はじめに
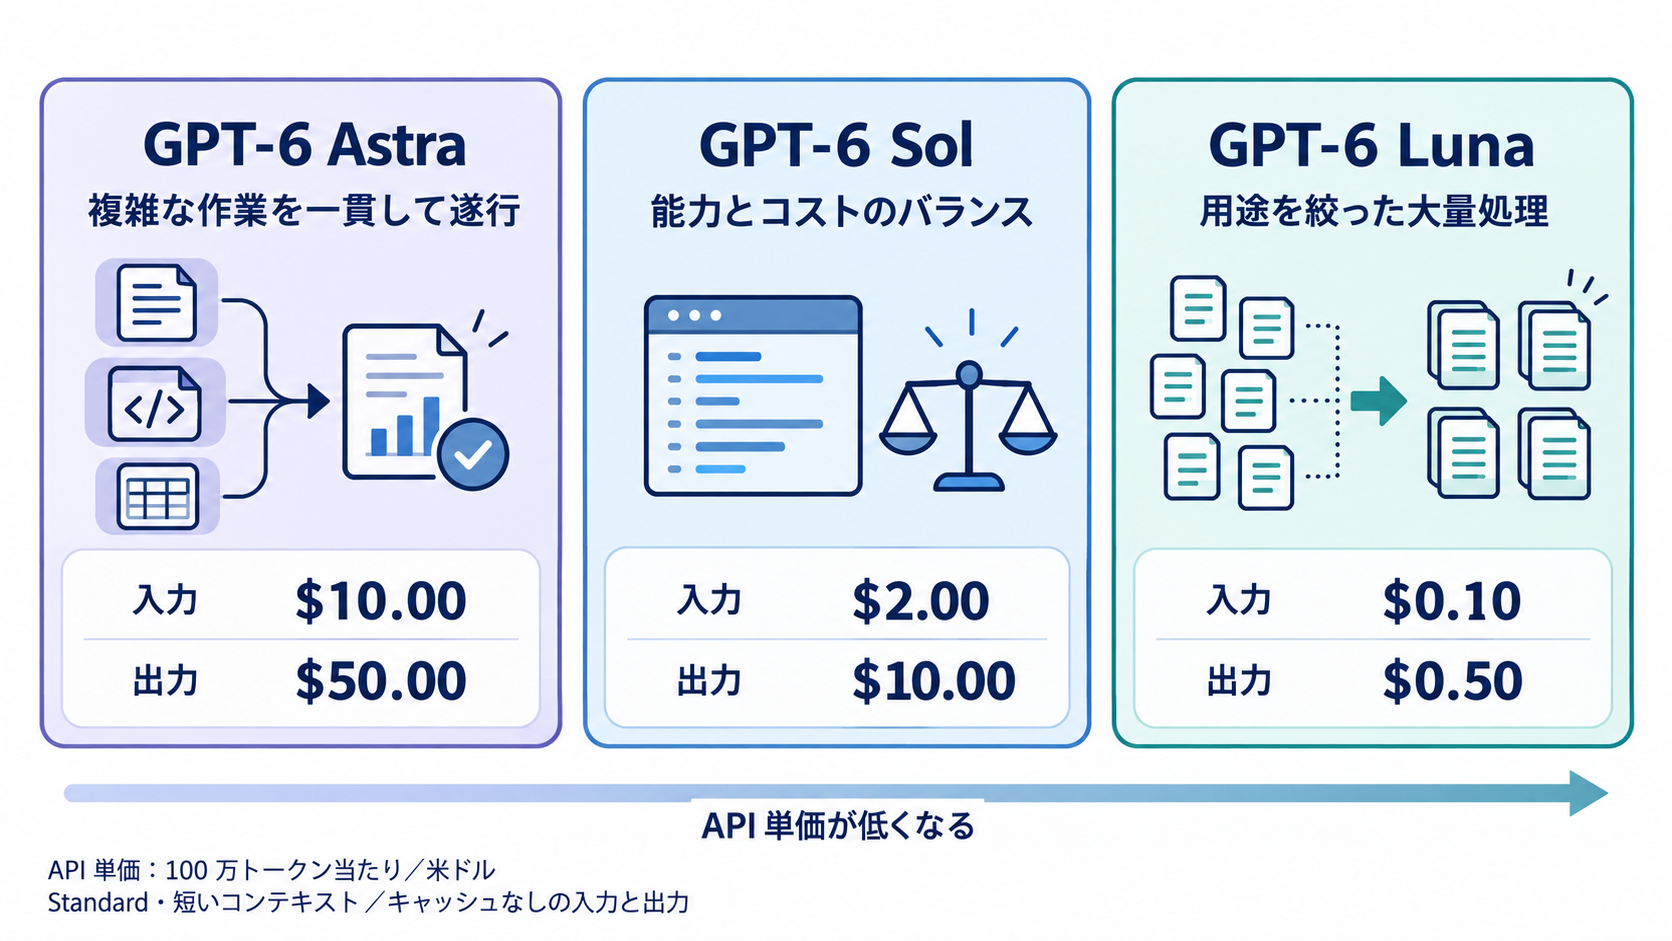
2026 年 9 月 22 日(米国時間)、OpenAI が GPT-6 Sol と GPT-6 Luna を発表しました。9 月上旬に公開された最上位モデル GPT-6 Astra に続くモデルで、同じ世代の能力をより低い単価で提供する位置づけです。
ただし、発表内容をそのまま業務の判断に使うには注意が必要です。ChatGPT では通常の Chat ではなく Work と Codex から提供が始まっており、API の値下げ率も比較元の価格によって見え方が変わります。公表されたベンチマークも、推論設定と評価対象を確認しなければ、自社の業務に当てはまるかどうかを判断できません。
この記事では、OpenAI の公式情報をもとに Sol と Luna の違い、利用環境ごとの提供条件、API 料金と実効コストの確認点を整理し、業務で試すモデルと評価方法を判断できるところまで落とし込みます。
- GPT-6 Sol・Luna の位置づけと、GPT-6 Astra・GPT-5.6 との関係
- 通常の Chat、ChatGPT Work、Codex、OpenAI API ごとの提供条件
- API 単価、値下げ率の比較元、キャッシュや長い入力の割増を含む実効コストの見方
- ログ分類、手順書の要約、スクリプト作成、障害調査で最初に試すモデルの候補
- 同じ入力と合格条件で Sol と Luna を比較する評価手順
先に結論を示します。Sol は複雑なコーディングとエージェント型の作業向け、Luna は範囲が明確な大量処理向けのモデルで、API の標準単価は 100 万トークンあたり Sol が入力 $2・出力 $10、Luna が入力 $0.10・出力 $0.50 です。ChatGPT では Plus 以上のプランの Work と Codex で段階的に提供されており、通常の Chat では執筆時点(2026 年 9 月 24 日)で利用できません。同じトークン量なら Luna の費用は Sol の 20 分の 1 ですが、採用は単価ではなく、必要な品質に達するまでの費用と手間で判断することをおすすめします。
GPT-6 Sol・Luna の違いと Astra との関係
Sol と Luna は、同じ GPT-6 世代のなかで能力とコストの配分を変えたモデルです。まず公式の位置づけと主な仕様を並べ、次に Astra と GPT-5.6 との関係、公表評価の読み方を整理します。
公式の位置づけと主な仕様
| 項目 | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| 公式の位置づけ | 複雑なコーディングとエージェント型ワークフロー向け | 範囲が明確な大量処理向けの、最も効率的なモデル |
| モデル ID | gpt-6-sol | gpt-6-luna |
| API 標準単価(入力 / 出力) | $2 / $10 | $0.10 / $0.50 |
| コンテキストウィンドウ | 1,050,000 トークン | 1,050,000 トークン |
| 最大出力トークン | 128,000 トークン | 128,000 トークン |
| 知識カットオフ | 2026 年 4 月 20 日 | 2026 年 5 月 18 日 |
| 入力 / 出力 | テキスト・画像 / テキスト | テキスト・画像 / テキスト |
推論設定(reasoning.effort) | none〜max の 6 段階(既定は medium) | none〜max の 6 段階(既定は medium) |
| ファインチューニング | 非対応 | 非対応 |
仕様上の違いは、単価と知識カットオフ程度です。コンテキスト長、最大出力、推論設定の段階は同じであるため、両者の差は「扱える量」ではなく、同じ設定で得られる品質と単価の配分にあると捉えると整理しやすくなります。
API で Web 検索、ファイル検索、Code Interpreter、Computer use、MCP などのツールを使う場合は Responses API が前提です。Chat Completions で関数呼び出しを使えるのは、推論設定が none の場合に限られます。仕様の出典は OpenAI のモデルページ(GPT-6 Sol、GPT-6 Luna)です。
Astra・GPT-5.6 との関係
GPT-6 世代の最上位は、9 月 3 日(米国時間)に公開された GPT-6 Astra です。OpenAI は今回の発表でも、最も要求が厳しく重要な作業には Astra が適するとしており、Sol と Luna は Astra と同様の手法で訓練した、より速く低コストなモデルと説明しています。API の標準単価は Astra が入力 $10・出力 $50 で、Sol の 5 倍、Luna の 100 倍です。Astra の仕様とプラン別の提供条件は、関連記事『GPT-6 Astra の料金と提供範囲|GPT-5.6 との使い分け』で整理しています。
GPT-5.6 との関係では、発表の価格比較が GPT-5.6 Sol から GPT-6 Sol、GPT-5.6 Luna から GPT-6 Luna への対応で示されています。GPT-5.6 の中位モデルだった Terra に対応する GPT-6 のモデルは、今回の発表には含まれていません。GPT-5.6 世代の 3 モデルの違いは、関連記事『GPT-5.6 Sol・Terra・Luna の違い|値下げ後の料金と使い分け』を参照してください。
公表評価から読み取れる範囲
発表には多数の評価結果が掲載されていますが、ここではモデル選択の判断材料になる 3 つに絞ります。いずれも OpenAI が公表した結果であり、第三者による検証ではありません。
| 評価 | 評価対象 | 公表された結果 | 読み方の注意 |
|---|---|---|---|
| AutomationBench 1.0.6 | 営業、マーケティング、財務、人事など 6 分野で 47 ツールを使う業務ワークフロー | Sol(xhigh)が 33.2%、タスクあたり費用 $0.27。Astra(low)は 30.3% で、タスクあたり費用は Sol の 3.9 倍。Luna(high)は前世代モデルから 5.4 ポイント改善し、タスクあたり費用は 58% 減 | Sol の比較相手は推論設定 low の Astra であり、Astra の上位設定との比較ではない |
| OpenAI 社内の事実性評価 | 過去のモデルの誤りをユーザーが指摘した、匿名化済みの ChatGPT の会話 | Sol の誤りは前世代モデルの約半分。Luna は高い推論設定で、GPT-5.6 Sol と同程度の結果を約 100 分の 1 のコストで達成 | 誤りが起きやすい会話を集めた評価で、通常利用での誤答率を示すものではない |
| DeepSWE 1.1 | 実在のコードベースでの長時間のソフトウェア開発タスク | Sol(max)が 68.8%、Luna(max)が 66.6% | 同じ max 設定での差は 2.2 ポイント。両者のタスクあたり費用の比較は公表されていない |
これらの結果から言えるのは、特定の評価セットと推論設定のもとでの傾向までです。「Sol は Astra より高性能」「Sol なら誤回答が半分になる」「Luna に切り替えれば必ず一定割合安くなる」といった一般化はできません。発表の注記でも、評価は研究環境または API で実施しており、システムプロンプトや利用できるツールの違いから、本番の ChatGPT とは出力が異なる場合があると説明されています。
Chat・Work・Codex・API の提供条件
提供条件は ChatGPT の中でも Chat・Work・Codex で異なり、API はさらに別の契約と課金体系です。「ChatGPT で使える」と一括りにせず、利用環境ごとに確認します。
利用環境別の提供状況
2026 年 9 月 24 日時点の公式情報をもとにした整理です。「提供対象(段階的に展開)」は提供対象に含まれるものの、アカウントによってはまだ表示されない状態を指します。
| 利用環境 | 対象プラン・契約 | GPT-6 Sol | GPT-6 Luna | 補足 |
|---|---|---|---|---|
| 通常の Chat | すべてのプラン | 未提供 | 未提供 | 発表と Help Center で Chat では利用できないと明記 |
| ChatGPT Work | Plus・Pro・Business・Enterprise・Edu | 提供対象(段階的に展開) | 提供対象(段階的に展開) | プラン、ワークスペース設定、展開状況に依存 |
| Codex | Plus・Pro・Business・Enterprise・Edu | 提供対象(段階的に展開) | 提供対象(段階的に展開) | デスクトップアプリ、CLI、IDE 拡張などで利用 |
| ChatGPT デスクトップアプリ | Free・Go | 対象外 | 提供対象(段階的に展開) | Luna を Standard 速度で提供 |
| OpenAI API | API 組織(Tier 1 以上) | 提供中 | 提供中 | Free ティアは非対応。料金は ChatGPT プランとは別の従量課金 |
参考: ChatGPT Work and Codex(OpenAI Help Center)
“They are not available in regular ChatGPT conversations.”
(GPT-6 Sol と GPT-6 Luna は、通常の ChatGPT の会話では利用できない)
https://help.openai.com/en/articles/20001275-chatgpt-work-and-codex
表の「提供対象」は、現在すぐに使えることを意味しません。OpenAI は ChatGPT での提供を段階的に進めると説明しており、対象プランであってもモデルピッカーに表示されるまで時間差があります。また、Plus 以上のプランと Free・Go では条件が異なり、Free・Go で使えるのはデスクトップアプリの Luna に限られます。
モデルが表示されない場合の確認点
- 通常の Chat ではなく、Work または Codex を選択しているか
- 利用中のプランが提供対象に含まれるか(Free・Go はデスクトップアプリの Luna のみ)
- Business・Enterprise・Edu では、ワークスペース設定とロールの権限で Work・Codex と対象モデルが許可されているか
- 段階的な展開の途中ではないか(時間をおいて再確認)
Enterprise などのワークスペース管理者は、Workspace settings の Models で Work・Codex の開始時の既定モデルや推論レベルを設定できます。ただし、既定値の設定はロールで利用できないモデルへのアクセスを付与するものではないため、権限側の設定もあわせて確認することをおすすめします。
ChatGPT の利用枠とクレジットへの影響
ChatGPT Work と Codex は利用枠を共有しており、プラン内の利用はドル建てではなく、モデルごとのクレジットレートで消費されます。Codex の料金ページでは、GPT-6 Sol・Luna のクレジットレートが GPT-5.6 の同名モデルより低く設定されています。
| モデル | クレジット(入力 / キャッシュ入力 / 出力、100 万トークンあたり) | Plus の 5 時間あたりのローカルメッセージの目安 |
|---|---|---|
| GPT-6 Sol | 50 / 5 / 250 | 15〜150 |
| GPT-5.6 Sol | 100 / 10 / 500 | 10〜100 |
| GPT-6 Luna | 2.5 / 0.25 / 12.5 | 350〜3,000 |
| GPT-5.6 Luna | 5 / 0.5 / 30 | 250〜2,000 |
目安の幅が広いのは、タスクの規模、投入したコンテキスト、推論設定、ツールの利用、キャッシュの効き方によって消費量が変わるためです。
参考: Pricing(Codex 公式ドキュメント)
“These estimates are not fixed message limits”
(これらの目安は、固定のメッセージ上限ではない)
https://developers.openai.com/codex/pricing
注意したいのは、API の値下げと ChatGPT の料金を混同しないことです。今回の発表に ChatGPT プランの月額料金の変更は含まれていません。プラン内での影響は「同じ利用枠で実行できる量の目安が増える」形で現れるもので、実行回数が保証されるわけではありません。Codex の料金ページも、クレジットレートだけでサブスクリプションの利用量が決まるわけではないとしています。なお、Codex に API キーでサインインした場合は、プランの枠ではなく API 料金の従量課金になります。
GPT-6 Sol・Luna の API 料金と実効コスト
API 料金は、単価そのものに加えて「何と比べた値下げなのか」と「単価表に現れない条件」を確認することが重要です。このセクションの単価は、特記がない限り Standard 処理、入力 272K トークン以下、100 万トークンあたりの 2026 年 9 月 24 日時点の値です。
標準単価と値下げ率の比較元
| モデル | 入力 | キャッシュ入力 | キャッシュ書き込み | 出力 |
|---|---|---|---|---|
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 |
| GPT-6 Astra(参考) | $10.00 | $1.00 | $12.50 | $50.00 |
Sol と Luna は、入力・キャッシュ・出力のいずれも単価比がちょうど 20 倍です。そのため、トークン消費量が同じであれば Luna の費用は Sol の 20 分の 1 になります。実際の差を縮めたり広げたりするのは、モデルごとの推論トークン量、再試行の回数、人による修正の手間です。
参考: Introducing GPT-6 Sol and Luna(OpenAI 公式)
“reducing API prices for Sol and Luna by 50%”
(Sol と Luna の API 価格を 50% 引き下げる)
https://openai.com/index/introducing-gpt-6-sol-and-luna/
発表では両モデルとも 50% の値下げと表記されていますが、比較元と具体的な単価を確認すると、項目ごとに減少率が異なります。
| 比較 | 入力 | 出力 | 比較元の条件 |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | $4 → $2(50% 減) | $20 → $10(50% 減) | 発表時点の GPT-5.6 Sol のプロモーション価格 |
| GPT-5.6 Luna → GPT-6 Luna | $0.20 → $0.10(50% 減) | $1.20 → $0.50(約 58.3% 減) | 2026 年 7 月 30 日の改定後の価格 |
| 参考: GPT-5.6 Sol → GPT-6 Sol | $5 → $2(60% 減) | $30 → $10(約 66.7% 減) | 2026 年 7 月 30 日の改定時点の価格 |
Luna の出力単価は $1.20 から $0.50 への変更で、計算上は約 58.3% 減です。また、GPT-6 Sol の比較元は GPT-5.6 Sol のプロモーション価格であり、7 月 30 日の改定時点の $5 / $30 とは異なります。OpenAI の料金表では、GPT-5.6 Sol のプロモーション価格は少なくとも 2026 年 11 月 21 日まで提供されると案内されています(Pricing)。値下げ率は比較元によって変わるため、見積もりには率ではなく具体的な単価を使うことをおすすめします。
実効コストを左右する条件
実際の請求額は「単価 × 消費トークン量」に、次の条件が加わって決まります。
- キャッシュ読み取り
-
繰り返し送る入力のうちキャッシュに一致した部分は、通常の入力単価の 10% で課金されます。Sol は $0.20、Luna は $0.01 です。OpenAI は GPT-6 向けにプロンプトキャッシュのヒット率を改善したと説明しています。
- キャッシュ書き込み
-
キャッシュへの書き込みは、通常の入力単価の 1.25 倍で課金されます。システムプロンプトやツール定義など毎回同じ部分を先頭にまとめ、書き込みが毎回発生しない構成にすることで割増を抑えられます。
- 272K トークンを超える入力
-
入力が 272K トークンを超えると、超過分だけでなくリクエスト全体の入力とキャッシュが 2 倍、出力が 1.5 倍で課金されます。Sol は入力 $4・出力 $15、Luna は入力 $0.20・出力 $0.75 になります。
- 推論トークン
-
回答本文に表示されない推論のトークンも、出力トークンとして課金されます。推論設定を上げると出力側の消費が増えるため、実際の費用差は単価比どおりにならない場合があります。
- ツール料金
-
Web 検索は 1,000 回あたり $10 に加え、取得したコンテンツのトークンがモデルの単価で課金されます。ファイル検索は 1,000 回あたり $2.50 の呼び出し料金とストレージ料金がかかります。
- 処理モードとリージョン
-
Batch と Flex は Standard の 50%、Fast mode は 2 倍の単価です。データレジデンシー対応のリージョナル処理には 10% の上乗せがあり、Sol と Luna の EU データレジデンシーは Standard 処理のみ対応です。本記事の単価比較は、すべて Standard でそろえています。
単価と実効コストが一致しない例として、当ブログで GPT-5.6 Luna を実測した際には、低価格モデルが入力を最後まで読まずに回答した実行が多く、プロンプトの指示によって結果が大きく変わりました。これは GPT-5.6 での単一タスクの結果であり GPT-6 の性能を示すものではありませんが、単価の比較だけで切り替えを決めない理由として参考になります。詳細は関連記事『GPT-5.6 Luna 80% 値下げ|80 回の実測で分かった落とし穴』を参照してください。
業務別の選び方|最初に試すモデル
ここでは、仕様と公表評価を踏まえて、情シス・インフラ業務で最初に試すモデルの候補を整理します。以下は OpenAI が適性を保証したものでも、筆者が GPT-6 Sol・Luna で実測した結果でもなく、編集上の提案です。候補の妥当性は、次のセクションの手順により自社の業務データで確認することをおすすめします。
| 業務 | 最初に試す候補 | 候補とする理由 | 人が確認する点 |
|---|---|---|---|
| 件数・項目を指定したログの抽出や分類 | Luna | 範囲が明確な大量処理向けと位置づけられ、件数が多いほど単価差が効く。正解を用意しやすく、評価も容易 | 元データと抽出件数の突合、抽出漏れ、分類ルールにない値の扱い、ファイル末尾まで処理したか |
| 手順書の要約、定型報告書の下書き | Luna | 入出力の形式を固定しやすく、テンプレートとの差分で品質を確認できる | 手順の順序と前提条件、切り戻し手順の欠落、機器名・バージョン・数値の転記誤り、原文にない記述の混入 |
| PowerShell・Python スクリプトの作成や修正 | Sol(小規模な定型修正は Luna と比較) | Sol は複雑なコーディング向けと位置づけられ、コーディング評価の公表値もある | 検証環境での実行結果、削除や設定変更など破壊的な処理の有無、例外処理、認証情報の埋め込み、実行環境のバージョン差 |
| 複数資料を突き合わせる障害調査や設計レビュー | Sol(影響の大きい案件は Astra と比較) | 資料間の矛盾の検出には多段の推論が必要。長い資料を扱うため、272K トークン超の割増も考慮が必要 | 結論の根拠箇所(資料名、ログの行)の提示、事実と推測の区別、一次データでの再確認、確認対象から漏れた資料の有無 |
上位モデルを選んでも、人の確認が不要になるわけではありません。特に障害調査や設計レビューのように判断の影響が大きい作業では、モデルの出力を調査の起点として扱い、結論は一次データで確認する運用を推奨します。
業務データで試す前に、ワークスペースのデータ取り扱い設定と社内規程を確認しておくことをおすすめします。認証情報、顧客情報、実機の設定ファイルは、マスキングしてから評価用データにする運用が安全です。
小さく試す評価手順|合格までの費用で比較
Sol と Luna のどちらを採用するかは、同じ入力と合格条件で比較して判断します。大規模なベンチマークではなく、10〜20 件程度の業務データで判断材料を得ることを目的とした手順です。
確認軸と記録項目
| 確認軸 | 記録する内容 | 判定の例 |
|---|---|---|
| 抽出漏れ | 正解に含まれる項目のうち、出力にない件数 | 0 件で合格 |
| 事実誤認 | 入力にない情報や、誤った数値・名称の件数 | 0 件で合格 |
| 指示遵守 | 出力形式、件数、禁止事項などの指示に対する違反の件数 | 違反なしで合格 |
| 所要時間 | 実行開始から、合格した出力を得るまでの時間 | 業務上の許容時間内 |
| 再試行 | 合格に達するまでの再実行やプロンプト修正の回数 | モデル間で比較 |
| 人の修正量 | 出力を業務で使える状態にするまでの修正時間 | 分単位で記録して比較 |
| トークン使用量と実費(API) | 入力、キャッシュ入力、出力(推論を含む)のトークン数と金額 | 合格した実行までの合計で比較 |
記録用の表は、次の列を用意しておくと集計しやすくなります。
case_id,model,reasoning_effort,run,pass,missed_items,factual_errors,instruction_violations,elapsed_sec,retries,edit_minutes,input_tokens,cached_input_tokens,output_tokens,cost_usd評価の進め方
実業務から 10〜20 件を選び、機密情報をマスキングしたうえで、人が正解と合格条件を作成します。件数や項目が決まっている業務では、正解を数値で持っておくと抽出漏れを機械的に判定できます。
同じプロンプト、同じ入力、同じ推論設定(まずは既定の medium)で両モデルを実行します。出力の揺れを確認するため 1 件につき複数回実行し、条件を変える場合は一度に 1 つだけ変えます。
前述の確認軸で出力を採点し、合否と修正時間を記録します。API ではレスポンスの usage に記録されたトークン数から実費を計算し、Work・Codex では使用量ダッシュボードで消費を確認します。Codex CLI では /status で残りの利用枠を確認できます。
1 件あたりの費用を「合格に達するまでの API 実費(再試行を含む)」と「人の修正時間」の合計で比較します。Luna の合格率が低く再試行や修正が増える場合は、プロンプトで完了条件と出力形式を明示してから再評価し、それでも不足する場合に Sol を採用する流れが合理的です。
合格率と費用の基準を決めて採用するモデルを確定し、モデルの更新や料金改定のたびに同じデータで再評価します。評価データを残しておくと、将来のモデル切り替えも同じ基準で判断できます。
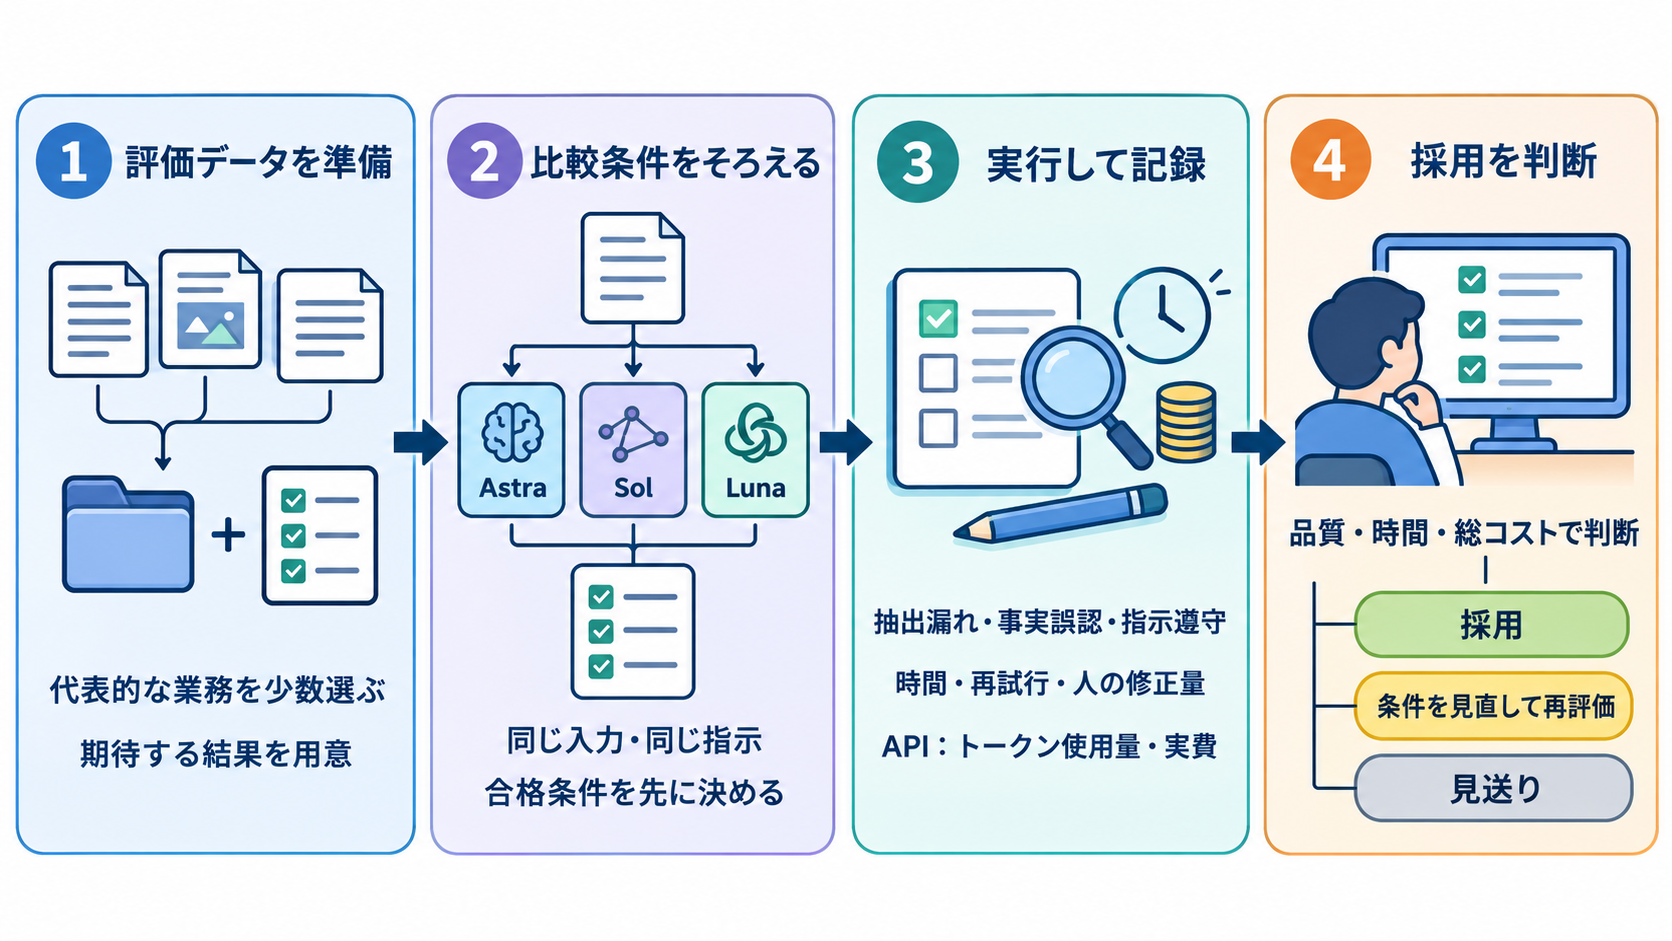
単価だけの試算を示すと、1 件あたり入力 20,000 トークン、出力 2,000 トークンの処理では、Luna が約 $0.003、Sol が約 $0.06 です。1,000 件でも Luna は約 $3、Sol は約 $60 にとどまります。一方で、人の修正が 1 件あたり 1 分増えると、1,000 件では約 17 時間の差になります。大量処理ほど、API 単価の差より人の修正量の差が総コストを左右するため、評価では修正量の記録を省略しないことをおすすめします。
まとめ
GPT-6 Sol と Luna は、Astra と同世代の能力を異なるコスト配分で提供するモデルです。ChatGPT では通常の Chat ではなく Work と Codex から段階的に提供されており、API の値下げ率は比較元によって見え方が変わります。業務への採用は、公表評価や単価ではなく、自社のデータで合格までの費用と手間を比べて判断することが出発点になります。
- 複雑なコーディングとエージェント型の作業に向く GPT-6 Sol
- 範囲が明確な大量処理に向く、最も効率的な GPT-6 Luna
- 通常の Chat は未提供、Plus 以上は Work と Codex で段階的に提供
- Free・Go の提供対象はデスクトップアプリの Luna のみ
- 同じトークン量なら Luna の API 費用は Sol の 20 分の 1
- 値下げ率は比較元で変わるため、見積もりは具体的な単価が基準
- 採用判断の基本は、合格までの費用と人の修正量の比較
以上、最後までお読みいただきありがとうございました。