はじめに
2026 年 9 月 15 日、米 TypeSafe AI が「System One Models」という新しいモデル区分と、その最初の公開モデル「Jev」を発表しました。問い合わせの分類や振り分けのように、プログラムの中で判断を下す処理に特化し、文章を生成しない点が特徴です。
発表には「ハルシネーションしない」「既存 LLM より 2 桁速く効率的」といった強い主張が並びます。一方で、社内の自動化へ組み込むかを判断するには、何が保証され、何が保証されないのかを切り分けておく必要があります。
- TypeSafe AI・System One Models・Jev の関係と、判断を受け取る仕組み
- 既存 LLM の構造化出力と Jev の違い
- 「ハルシネーションなし」「193.6 倍速い」という主張の前提
- 社内問い合わせの振り分けを例にした、AI・コード・人の役割分担
- 試す前に確認したい判断基準と、公開資料で確認できない事項
結論を先に示します。Jev は、あらかじめ定義した候補や尺度の中から判断を返し、その確率をコードで扱うためのモデルです。保証されるのは返り値の型と候補の範囲であり、判断内容の正しさではありません。速度と価格の倍率も同社の特定ワークフロー評価に基づく値のため、試す場合は自社の正解付きデータで精度、処理時間、費用、人へ戻る割合を測ることをおすすめします。
なお、本記事は 2026 年 9 月 16 日時点の公式情報に基づく解説です。筆者は Jev を実行しておらず、記事内の JSON は設計例であり実行結果ではありません。
TypeSafe Jev と System One Models の概要
最初に名称を整理し、Jev へ何を渡して何が返るのかを確認します。
提供元・モデル区分・モデル名の関係
- TypeSafe AI
-
開発・提供元の企業です。創業者の Diogo Almeida 氏は、OpenAI で ChatGPT の基礎となった研究に携わったと発表で述べています。同日のプレスリリースでは、4,000 万ドルの資金調達も公表されました。
- System One Models
-
同社が定義したモデル区分です。ソフトウェアがそのまま使える構造化された判断を、高速に返すことを目的としています。名称は、ダニエル・カーネマンが示した速く直感的な「システム 1」の思考に由来します。
- Jev
-
System One Models の最初の公開モデルです。API では
jev-latestとして指定します。名称は、経済学者ウィリアム・スタンレー・ジェヴォンズに由来します。
学習手法として、同社は RLCD(Reinforcement Learning for Calibrated Decisions)を挙げています。人が好む文章を目指す RLHF とは異なり、判断に付く確率が実際の正答率と整合すること(キャリブレーション)を目的とした手法と説明されています。
state と questions で判断を受け取る仕組み
API には、判断材料となる state と、型付きの質問をまとめた questions を送ります。state は文字列のほか JSON のオブジェクトや配列も指定でき、問い合わせ本文と関連情報を名前付きでまとめて渡せます。
質問の型は次の 3 種類です。1 回のリクエストに複数の型を混在させることができ、各質問は同じ state に対して並列かつ独立に評価されます。
| 型 | 何を質問するか | 何が返るか |
|---|---|---|
| Choice | 定義した選択肢から 1 つを選ぶ(選択肢は最大 255 個) | choice(最も確率が高い選択肢)、probabilities(全選択肢の確率)、confidence |
| Score | 定義した段階(2 段階以上)のどこに当たるか | score(確率で重み付けした値で、段階の間の小数になり得る)、legend、probabilities、confidence |
| Noul | ある記述が真かどうか | noul(0〜1 の値で、1 に近いほど「はい」)。confidence は返らない |
公式ドキュメントは、1 つの質問に 1 つの論点だけを持たせ、複数の要素を比べる判断は質問を分けてコード側で組み合わせる設計を推奨しています。重み付けを変えたいときは、プロンプトを書き直すのではなくコードの係数を変更する、という考え方です。
参考: Introduction(TypeSafe 公式ドキュメント)
“No text generation, no parsing.”
(自由文を生成しないため、生成された文章を後から解析する必要もない)
https://docs.typesafe.ai/introduction
自由文を生成しないモデル
Jev は文字列を生成しません。回答は、事前に定義した型の値と確率だけです。そのため、要約、メール文面の作成、コード生成、判断理由の説明といった用途には使えません。
汎用 LLM を置き換えるモデルではなく、ルールベースの処理や LLM と組み合わせて、分岐の判断を担う部品として捉えるのが適切です。公式ドキュメントにも、分類結果に応じて定型処理、専門の LLM、人のいずれかへ振り分けるパターンが掲載されています。
構造化出力との違いと「ハルシネーションなし」の範囲
Jev の特徴は、型の保証と確率の返却にあります。ただし、型の保証は既存 LLM の機能でも一定の範囲で実現でき、どちらも判断の正しさを保証するものではありません。
既存 LLM の構造化出力との比較
主要な LLM API も、JSON スキーマへの適合を保証する機能を提供しています。OpenAI は Structured Outputs を、Anthropic は Claude API の structured outputs(JSON outputs と strict tool use)を公式に案内しており、対応モデルとサポート対象のスキーマの範囲では、出力形式の崩れを防げます。
参考: Structured model outputs(OpenAI 公式ドキュメント)
“only Structured Outputs ensure schema adherence”
(JSON モードと比べ、スキーマへの適合を保証するのは Structured Outputs のみ)
https://developers.openai.com/api/docs/guides/structured-outputs
| 観点 | Jev | 汎用 LLM の構造化出力 |
|---|---|---|
| 型・スキーマへの適合 | 定義した型と選択肢以外は返らないと同社は説明 | 対応モデルとサポート対象のスキーマの範囲で保証。機能を使わない場合は保証されない |
| 判断内容の正確性 | 保証されない | 保証されない |
| 確率の扱い | Choice と Score に確率分布と confidence、Noul に 0〜1 の値が付く | 構造化出力の値そのものに確率は付かない。必要な場合は別途の工夫が要る |
| 処理方式 | 全質問の出力を 1 回のクエリで並列に算出 | トークンを 1 つずつ順に生成 |
| 自由文の生成 | 不可 | 可能(説明、要約、コード生成など) |
形式の保証だけを比べれば、差は小さくなります。Jev の違いは、判断ごとに確率が返ることと、文字列生成を持たない設計によって処理時間と費用を抑えていると同社が説明している点にあります。
また、発表内のハルシネーション・型エラーの比較グラフについて、同社は LLM 側の数値を OpenRouter 由来のデータとし、Jev 側の 0% は実測値ではなくスキーマ適合が保証されることから置いた値だと注記しています。
型の保証と判断の正しさは別
同社の「ハルシネーションしない」は、定義した型や候補の外にある値を返さない、という意味で読むのが妥当です。候補の中から選ぶことは保証されても、選ばれた候補が正しいとは限りません。
例えば、社内問い合わせを「情報システム」「総務」「人事」の 3 窓口へ振り分ける Choice を定義したとします。「異動に合わせて PC とアカウントを移したい」という問い合わせに対し、定義していない「IT 部」が返ることはありません。しかし、社内の運用上は人事手続きが先に必要な場合でも、「情報システム」が選ばれる可能性は残ります。これは、形式上は正しい誤分類です。
公式ドキュメントの Choice の例でも、サイズ違いと二重請求を同時に訴える問い合わせで、返品担当が 0.60、請求担当が 0.38 と確率が分かれています。候補の範囲が守られていても、判断が割れる入力は存在します。
出力の形式と内容の正しさを分けて確認する考え方は、構成図の生成を比較した『AI でシステム構成図は作れるか|4 環境の初回出力と確認ポイント』でも扱いました。対象は画像出力で異なりますが、表記が整っていても関係性の誤りが残り得る点は共通しています。
probabilities と confidence の違い
Choice と Score の回答には、候補ごとの確率を並べた probabilities と、その分布の形を 1 つの数値に集約した confidence が含まれます。両者は別の値です。
- probabilities
-
Choice では選択肢ごと、Score では段階ごとの確率で、合計は 1 になります。1 位の候補だけでなく、2 位以下にどれだけ確率が残っているかを確認できます。
- confidence
-
probabilities の分布から算出される 0〜1 の統計量です。1 つの候補に確率が集中していれば高く、複数に分散していれば低くなります。Noul には付きません。
- noul
-
Noul の回答値で、記述が真である確率を 0〜1 で示します。
公式ドキュメントは confidence を多くの用途に合う既定の指標と位置付け、用途によっては probabilities から別の指標を計算してよいとしています。公式のコード例には 0.5 や 0.9 といった基準値が登場しますが、これは例示です。
confidence が 0.9 であっても、その業務で 90% 正解することを意味するわけではありません。同社は確信度が高いほど正答率も高くなるよう調整していると説明していますが、自社の問い合わせの傾向や日本語の表現で同じ関係が成り立つかは、自社データで確かめることをおすすめします。
参考: Confidence(TypeSafe 公式ドキュメント)
“test with your own data, and adjust as you observe results”
(自社のデータで試し、結果を観察しながら調整する)
https://docs.typesafe.ai/confidence
速度・価格の主張と評価条件
発表で特に目を引くのは、193.6 倍の速度と 444.6 倍の価格差です。これらは、同社が作成した 4 つのワークフロー評価に基づく値として読む必要があります。
公表されている料金と応答時間
| 項目 | 公式の記載 |
|---|---|
| 入力トークン | 100 万トークンあたり 0.042 ドル(10 億トークンあたり 42 ドル) |
| 出力トークン | 無料(計測するまでもない安さと説明) |
| 使用量の確認 | API 応答の usage に input_tokens と output_tokens が返る |
| 応答時間 | エンドツーエンドで 70〜500 ms(発表ブログの比較表) |
| サービス拠点 | 米国西海岸。公開評価も同地域の手元環境から実行したと説明 |
価格について同社は、補助的な価格でないことを現時点では証明できず、持続性は長期的に示すと述べています。また、同日のプレスリリースでは「100 ms 未満」「最大 100 倍」と、ブログとは異なる表現が使われています。数値を社内資料へ引用する際は、どの資料のどの条件の値かを併記することをおすすめします。
Workflow evals の前提と読み方
193.6 倍と 444.6 倍の出どころは、同社の評価サイト「Workflow evals」です。セキュリティアラート対応、サポートエージェントの実行ログ確認、請求書処理、カスタマーサービスの 4 ワークフローで、各モデルの一致率、費用、処理時間を比較しています。
| 前提 | 内容 | 読み方の注意 |
|---|---|---|
| 正解の定義 | GPT-6 Astra と Claude Fable 5.1(いずれも高い推論設定)の回答の平均を参照ラベルとする | 人が確認した業務上の正解ではなく、参照モデルとの一致率として読む |
| ワークフロー | 同社のモデル能力チームのメンバーが作成。学習データには含まれないと説明 | 作成者によるバイアスの可能性を同社自身が認めている |
| 比較対象の設定 | 比較対象の LLM は各社の既定の推論設定で実行 | 推論設定を変えると結果が変わる可能性がある |
| 確率の出力 | LLM も System One Adapter 経由で確率付きの判断を出力 | 確率を求めない通常の呼び出しより遅く高価になる傾向があると同社は説明 |
| 参照ラベルの偏り | 参照が OpenAI と Anthropic のモデルに基づく | 同社は Jev と DeepSeek の性能を低めに見積もっている可能性に言及 |
参考: Introducing System One Models & Jev(TypeSafe 公式ブログ)
“we expect that these are on the higher end of real world gains”
(これらの倍率は、実環境で得られる改善幅の中でも高い側だと想定している)
https://typesafe.ai/blog/introducing-system-one-models-and-jev
評価サイトの全体グラフは、4 ワークフローを等しい重みで平均し、各モデルを提供元の既定の推論設定で実行した結果です。この平均で、Jev(workflow 方式)の一致率は 67.8%、1 件あたりの費用は 0.0004 ドル、処理時間は 0.4 秒と表示されています。同じ workflow 方式では、Opus 5 が 73.1%、評価サイト上で「sol」と表記されたモデルが 74.1% で、Jev を上回っています。Jev が優位なのは費用と速度に対する一致率であり、一致率そのものが最も高いわけではありません。ワークフロー別に見ると、請求書処理での Jev の一致率は 61.8% で、workflow 方式の比較対象のうち Haiku 4.5(42.9%)を除くすべてを下回っています。
倍率の算出に使った比較対象の組み合わせは、確認した公開資料では明示されていません。また、日本からの応答時間と、日本語の入力での精度は公開資料では確認できず、本記事でも検証していません。
発表ブログのデモでは、Jev の比較対象として GPT-5.6 Terra が使われています。GPT-5.6 各モデルの位置付けは『GPT-5.6 Sol・Terra・Luna の違い|値下げ後の料金と使い分け』で整理しています。
業務自動化での設計例|社内問い合わせの振り分け
ここでは、社内の IT・総務系問い合わせの一次振り分けを題材に、Jev を組み込む場合の役割分担を整理します。公式ドキュメントの考え方をもとにした編集上の設計例であり、実装・検証したものではありません。
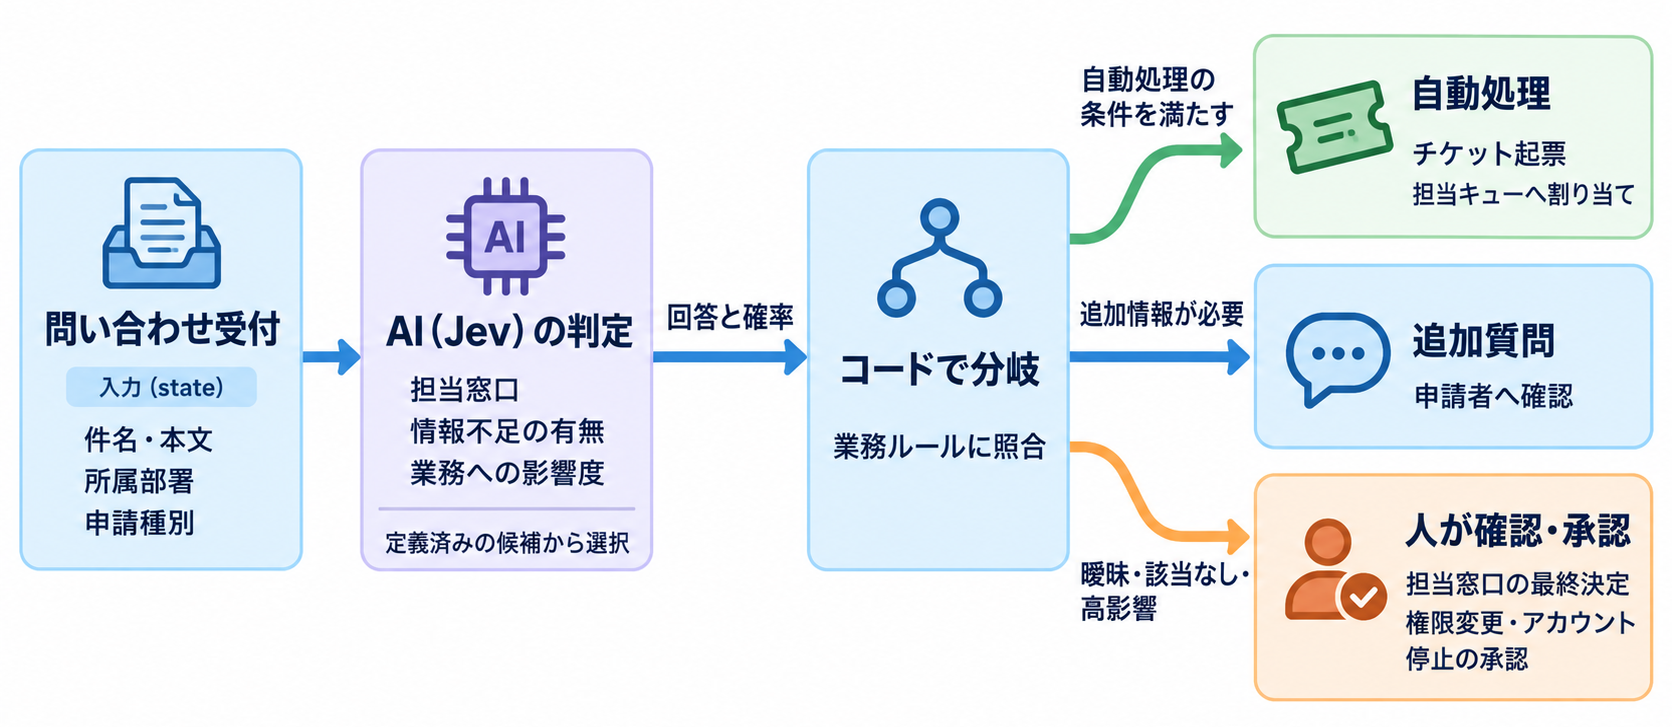
AI・コード・人の役割分担
| 担い手 | 役割 | 具体例 |
|---|---|---|
| 入力(state) | 判断に必要な情報をまとめて渡す | 問い合わせの件名と本文、申請者の所属部署、申請フォームで選ばれた申請種別 |
| AI(Jev) | 定義済みの候補や尺度で判断する | 担当窓口の分類、情報不足の有無、業務への影響度の判定 |
| コード | 回答と確率を読み、所定の処理へ分岐する | チケット起票、担当キューへの割り当て、申請者への追加質問 |
| 人 | 曖昧な問い合わせ、情報不足、影響の大きい判断を確認する | 窓口の最終決定、権限変更やアカウント停止を伴う依頼の承認 |
リクエストの設計例
API リファレンスの構造に沿って質問を定義した例です。選択肢に「該当なし」を用意し、候補外の問い合わせを受け止められるようにしています。申請種別は申請フォームで選択された値をそのまま state に含めています。選択肢の説明を日本語で書いた場合の精度は、公開資料では確認できていません。
{
  "state": {
    "subject": "PC の入れ替えについて",
    "body": "来月の異動に合わせて PC とアカウントを移したいです。",
    "requester_department": "営業部",
    "request_type": "端末・アカウントの移行"
  },
  "model": "jev-latest",
  "questions": {
    "desk": {
      "type": "choice",
      "instructions": "この問い合わせを担当する窓口はどれか",
      "criteria": {
        "it": "PC、アカウント、ネットワーク、業務システムの不具合や設定",
        "general_affairs": "備品、施設、郵便、座席",
        "hr": "異動、休職、各種届出などの人事手続き",
        "none": "上記のいずれにも該当しない"
      }
    },
    "missing_info": {
      "type": "noul",
      "instructions": "対応に必要な情報(対象機器、希望日など)が不足している"
    },
    "business_impact": {
      "type": "score",
      "instructions": "業務への影響度",
      "criteria": ["影響なし", "一部の作業に支障がある", "業務が停止している"]
    }
  }
}
回答は answers の下に、deskmissing_infobusiness_impact の各キーで返ります。コード側は、この値を読んで次のように分岐させる想定です。
| 条件 | コードの処理 |
|---|---|
| API エラー、タイムアウト、再試行の上限到達 | 理由を「判定不能(API 障害)」として記録し、人の振り分けキューへ回す |
desk が none | 理由を「該当なし(判定結果)」として記録し、人の振り分けキューへ回す |
missing_info の値が高い | 申請者へ追加情報を依頼する |
desk の confidence が業務ごとに定めた基準を下回る | 人が窓口を決定する |
| 申請フォームの申請種別が権限変更やアカウント停止 | AI の判定にかかわらず、窓口へ割り当てたうえで実行前に人が承認する |
business_impact の値が「業務が停止している」に近い | 担当窓口の優先対応キューへ入れる |
| 上記以外 | 判定された窓口のキューへ自動で割り当てる |
影響の大きい依頼は、AI の判定ではなく申請種別という入力情報でコードが判定する設計にしています。business_impact は対応の優先度を決めるためだけに使います。
2 位の候補にも一定の確率が残る場合は、その窓口へ写しを共有する使い方も考えられます。公式ドキュメントの Choice の例でも、確率が一定以上残る別の担当へ通知する分岐が示されています。
API 障害と判定不能時の扱い
Jev は外部の API サービスとして提供されます。公式 API リファレンスには、レート制限超過を示す 429 Too Many Requests と、一時的な過負荷を示す 529 Overloaded が記載されており、指数バックオフでの再試行が案内されています。Python SDK は既定のリトライポリシーを備え、HTTP 操作ごとの既定のタイムアウトは 10 秒です。
再試行しても応答が得られない場合は、受付を止めずに人の振り分けへ戻す経路を用意しておくことを推奨します。行き先は「該当なし」と同じ人の確認で構いませんが、正常な判定結果としての「該当なし」と、API 障害で判定できなかった状態は、理由を分けて記録することをおすすめします。混在させると、障害の切り分けや、人へ戻る割合の評価が正しく行えなくなります。
自動処理の割合を上げることより先に、人へ戻った問い合わせの担当者と対応期限を決めておくと、試行時の滞留を防ぎやすくなります。
試す前の判断基準と評価の進め方
Jev が向くかどうかは、モデルの性能以前に、業務の判断を型として定義できるかで決まります。次の 6 点を確認してから試すことをおすすめします。
適性を見極める 6 つの確認点
| 確認点 | 見るべき内容 | 当てはまらない場合の考え方 |
|---|---|---|
| 判断候補を事前に定義できるか | 窓口、カテゴリ、段階などを列挙できる | 自由文の回答が必要なら汎用 LLM が適する |
| 単純なルールで処理しきれない部分があるか | 表現の揺れや文脈によって判断が変わる | キーワードや正規表現で足りるならルールで処理する |
| 誤分類の影響を許容できるか | 誤った窓口に届いても手戻りで回復できる | 影響の大きい判断は人の承認を前提にする |
| 正解付きの代表データで評価できるか | 過去の問い合わせと実際の担当窓口を揃えられる | 正解データの整備から始める |
| 日本語や曖昧な入力を含めて評価できるか | 略語、複数の論点、情報不足の問い合わせを含む | 評価結果が実運用を反映しにくい |
| 精度以外の指標も測れるか | 処理時間、費用、人へ戻る割合を記録できる | 自動化の効果を判断しにくい |
自社データで評価する手順
窓口ごとの担当範囲と対象外を書き出し、Choice の選択肢と説明にします。「該当なし」の選択肢と、情報不足を確認する Noul もあわせて用意します。
過去の問い合わせに、人が確認した担当窓口を正解として付けます。日本語の略語を含むもの、複数の論点を含むもの、情報が不足しているものを意図的に含めます。
Playground または API で Jev を実行します。利用条件を確認するまでは、実データではなく架空の問い合わせを使います。LLM と比べる場合は、公式の System One Adapter を使うと、同じ質問定義を OpenAI や Anthropic のモデルで実行し、確率付きか値のみかを選んで比較できます。
全体の一致率に加え、1 件あたりの処理時間と費用、confidence の基準を変えたときに人へ戻る割合を記録します。あわせて、自動処理に回した案件だけの誤分類率も集計すると、人へ戻す割合を減らした際に自動処理側の誤りが増えていないかを判断できます。日本からの応答時間も、この段階で実測します。
窓口の誤りで生じる手戻りと、人が確認する工数を比べ、処理ごとに confidence の基準を決めます。影響の大きい処理ほど基準を高くするか、自動処理の対象から外します。
自動処理のしきい値は一律の値ではなく、業務ごとの誤判定コストと評価結果から決めることをおすすめします。公式ドキュメントも、同じシステム内で操作の影響度に応じて基準を変える設計を示しています。
利用開始の条件と未確認事項
早期アクセスと利用方法
2026 年 9 月 16 日時点で、Jev は早期アクセスとして提供されており、同社サイトの待機リストから順次利用者を受け入れる方式です。利用が認められると、Quick start に沿って次の方法で試せます。
- Web の Playground で state と質問を入力し、結果を確認する。
- ダッシュボードで API キーを発行し、
https://api.typesafe.ai/v1/systemoneへ POST する。 - Python SDK(
typesafe-sdk、Python 3.10 以上)または JavaScript SDK を使う。 - Claude Code などのコーディングエージェント向けに公開されている公式スキルを導入する。
業務データの扱いについて、同社のプライバシーポリシー(2025 年 11 月 19 日更新)は、利用者の入力を AI モデルの学習や微調整に使わないこと、サービス提供事業者以外の第三者へ開示しないことを記載しています。サービスは米国でホストされており、日本から利用する場合はデータが米国へ転送される前提になります。
一方、サイトで公開されている Terms of Use は Web サイト(Site)の利用条件で、個人利用に限定したライセンスや、機密情報・専有情報を送信しない旨が記載されています。この規約をそのまま API の商用利用条件と読むことはできず、API や早期アクセスに適用される契約条件は、確認した公開資料では特定できませんでした。
入力を学習に使わないことと、機密情報を送信してよいことは別の話です。適用される契約条件を確認するまでは、実際の問い合わせや社内情報を送信せず、架空のデータで試すことをおすすめします。
参考: Privacy policy(TypeSafe AI)
“The Services are hosted in the United States”
(本サービスは米国でホストされている)
https://typesafe.ai/legal/privacy-policy
導入前に確認したい未確認事項
次の項目は、確認した公開資料では記載を見つけられませんでした。非対応という意味ではなく、早期アクセスの申請時や契約前に確認したい事項として整理します。
| 項目 | 公開資料で確認できた範囲 | 確認したい内容 |
|---|---|---|
| 日本語対応 | 対応言語の記載なし | 日本語の state や選択肢説明での精度 |
| 入力上限 | state の形式(文字列、オブジェクト、配列)と Choice の選択肢上限 255 個 | 1 リクエストあたりのトークン上限、質問数の上限 |
| レート制限 | 429 の存在と再試行方法 | 具体的な上限値と引き上げ方法 |
| 提供地域 | サービスは米国でホスト | 日本からの利用条件、データ所在地の選択肢 |
| SLA・サポート | 記載なし | 稼働率の保証、障害時の連絡体制 |
| データ保持 | サービス提供に必要な期間保持すると記載 | 入力データの保持期間と削除方法 |
| API・早期アクセスの契約条件 | 公開 Terms of Use は Site の利用条件で、API への適用範囲は確認できず | 商用利用の可否、機密情報を送信できる条件、早期アクセス期間中の制約 |
まとめ
TypeSafe の Jev は、文章を生成せず、定義した型の判断と確率だけを返す業務自動化向けのモデルです。保証されるのは出力の型であり、判断の正しさや自社業務での精度は、正解付きのデータで評価して確かめることが前提になります。
- Jev は TypeSafe AI の System One Models 最初の公開モデル
- Choice・Score・Noul の型で判断と確率を返す仕組み
- 文章やコードは生成せず、汎用 LLM の代わりにはならない位置付け
- 型の保証は候補の範囲の保証であり、判断の正しさとは別物
- 193.6 倍・444.6 倍は同社の 4 ワークフロー評価に基づく値
- confidence の基準は誤判定コストと自社評価で業務ごとに決めます。
- 日本語精度、入力上限、SLA は申請時に確認したい未確認事項
以上、最後までお読みいただきありがとうございました。