はじめに
2026 年 9 月 29 日(米国時間)、OpenAI が GPT-6 Sol のアップグレード版となる GPT-6.1 Sol を公開しました。API の標準単価は GPT-6 Sol と同じ入力 $2・出力 $10 のまま、キャッシュ入力の単価が半分に引き下げられています。
ただし、既存の API 処理をモデル名だけ変えて切り替えられるとは限りません。GPT-6.1 Sol は推論設定 none に対応しておらず、Chat Completions でツールを呼び出す構成も使えません。GPT-6 Sol を none で運用している処理ほど、切り替え時に設定と評価の見直しが必要になります。
この記事では、OpenAI の公式情報をもとに、GPT-6 Sol からの変更点、Astra との料金比、ChatGPT と API の提供条件、API 移行時の互換性を整理し、切り替え前後の確認手順まで示します。本記事の性能値はいずれも OpenAI の公表値であり、当ブログで GPT-6.1 Sol を実測した結果ではありません。
- GPT-6.1 Sol の位置づけと、GPT-6 Sol から変わった仕様・単価
- Astra と比べて安くなる料金項目と、単価比とタスク費用の違い
- ChatGPT Work・Codex・API ごとの提供条件と管理者設定
- API のモデル ID だけを変えて移行できない構成と、その対応
- 旧 Sol から切り替える前後の確認手順と合格基準の決め方
先に結論を示します。GPT-6.1 Sol は、OpenAI が Astra に近い性能を低い単価で提供すると位置づける Sol 系の新モデルで、API の標準単価は据え置き、キャッシュ入力は 100 万トークンあたり $0.20 から $0.10 に下がりました。ChatGPT では Plus・Pro・Business・Enterprise・Edu の Work と Codex が提供対象で、通常の Chat では利用できません。API で GPT-6 Sol を推論設定 none で使っている処理や、Chat Completions でツールを呼び出している処理は、モデル ID の変更だけでは移行できません。
GPT-6.1 Sol とは|GPT-6 Sol からの変更点
GPT-6.1 Sol は、GPT-6 Sol のアップグレード版として公開されたモデルです。OpenAI は、エージェント型のコーディング、コンピューター操作、専門業務で Astra に近い性能を、Astra の標準入出力単価の 5 分の 1 で提供すると説明しています。ここでは仕様の差分を確認し、次に公表評価の読み方を整理します。
GPT-6 Sol との違い(仕様と単価)
単価は Standard 処理、入力 272K トークン以下、100 万トークンあたりの値です(2026 年 9 月 30 日確認)。
| 項目 | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| モデル ID | gpt-6-sol | gpt-6.1-sol |
| 標準単価(入力 / 出力) | $2.00 / $10.00 | $2.00 / $10.00(据え置き) |
| キャッシュ入力 | $0.20(入力単価の 10%) | $0.10(入力単価の 5%) |
| キャッシュ書き込み | $2.50 | $2.50 |
| 推論設定(reasoning effort) | none / low / medium / high / xhigh / max | low / medium / high / xhigh / max(none・minimal は非対応) |
| 既定の推論設定 | medium | medium |
| Chat Completions でのツール呼び出し | 推論設定が none の場合のみ関数呼び出しに対応 | 非対応(ツールなしのリクエストのみ) |
| データレジデンシー | EU は Standard・Flex・Batch で利用可 | US・EU に対応。EU では Fast mode を利用不可 |
| 知識カットオフ | 2026 年 4 月 20 日 | 2026 年 4 月 30 日 |
| コンテキスト / 最大出力 | 1,050,000 / 128,000 トークン | 1,050,000 / 128,000 トークン |
仕様上の主な変化は、キャッシュ入力の単価と、推論設定・Chat Completions の制約の 2 点です。コンテキスト長、最大出力、Responses API で使える組み込みツール(Web 検索、ファイル検索、Code Interpreter、Computer use、MCP など)は、モデルページ上で両モデルとも同じ内容です。出典は OpenAI のモデルページ(GPT-6 Sol、GPT-6.1 Sol)です。
参考: GPT-6.1 Sol Model(OpenAI API ドキュメント)
“The none and minimal reasoning efforts are not supported.”
(推論設定 none と minimal はサポートされない)
https://developers.openai.com/api/docs/models/gpt-6.1-sol
なお、API の料金表の主要モデル一覧は GPT-6.1 Sol に置き換わっており、GPT-6 Sol の単価はモデルページで確認しています。今回確認した公式ページには、GPT-6 Sol の API 提供終了時期は記載されていませんでした。Sol と Luna の使い分けなど GPT-6 世代全体の位置づけは、関連記事『GPT-6 Sol・Luna の違い|API 料金と業務利用での選び方』で整理しています。
公表評価の読み方
発表には多数の評価結果が掲載されていますが、情シス・インフラ業務に関係が深い 3 つに絞ります。いずれも OpenAI が公表した結果で、第三者による検証ではありません。
| 評価 | 評価対象 | 公表された比較 | 読み方の注意 |
|---|---|---|---|
| DeepSWE v1.1 | 実在のコードベースでの、長時間にわたる複雑なソフトウェア開発タスク | Astra と同等のスコアを、約 5 分の 1 の費用で達成。GPT-6 Sol の最高スコアを 6.4 ポイント上回る | GPT-6 Sol との比較は、6.1 Sol 側がより低い推論設定と費用で出した結果であり、同じ推論設定での比較ではない |
| GDP.pdf | 表、グラフ、図、細かい注記を含む PDF を使った、金融・医療・法務など 10 分野の専門的な質問への回答 | Astra の最高水準に近い結果を、タスクあたり約 5 分の 1 の費用で達成 | Astra とのスコア差は本文に数値の記載がない。社内手順書への当てはまりは自社データでの確認が必要 |
| AutomationBench 1.0.6 | 47 のツールを使う、営業・財務・人事などの複数工程の業務ワークフロー | 推論設定 medium で GPT-6 Sol を 4.8 ポイント上回る | 旧 Sol と同じ推論設定での比較。この評価での Astra との比較値は本文に記載がない |
「Astra に近い」は OpenAI の評価における位置づけであり、すべての業務で Astra の代替になることを示すものではありません。OpenAI 自身も、科学研究の評価では Astra が最も高いスコアだったとして、最も難しい研究タスクには Astra を使うよう案内しています。また、評価は研究環境または API で実施されており、システムプロンプトや利用できるツールの違いから、本番の ChatGPT とは出力が異なる場合があると注記されています。
事実性については、推論設定 low で事実の誤りを含む回答の割合が、GPT-6 Sol の 11.4% から 7.7% に下がったと公表されています。ただしこの評価は、過去のモデルの誤りをユーザーが指摘した会話を匿名化して集めたもので、通常利用での誤答率を示すものではありません。
参考: Introducing GPT-6.1 Sol(OpenAI 公式)
“These deliberately difficult prompts are not representative of typical usage.”
(これらの意図的に難しいプロンプトは、典型的な利用を代表するものではない)
https://openai.com/index/introducing-gpt-6-1-sol/
GPT-6.1 Sol の料金|Astra・旧 Sol との比較
料金は、比べる項目によって差の大きさが変わります。このセクションの単価も、Standard 処理、入力 272K トークン以下、100 万トークンあたりの値です(Pricing、2026 年 9 月 30 日確認)。
Astra と比べて安くなる料金項目
| 項目 | GPT-6.1 Sol | GPT-6 Astra | Sol の単価(Astra 比) |
|---|---|---|---|
| 入力 | $2.00 | $10.00 | 5 分の 1 |
| キャッシュ入力 | $0.10 | $1.00 | 10 分の 1 |
| キャッシュ書き込み | $2.50 | $12.50 | 5 分の 1 |
| 出力 | $10.00 | $50.00 | 5 分の 1 |
発表の「5 分の 1」は、標準の入力・出力の単価比です。キャッシュ入力は、GPT-6.1 Sol が入力単価の 5%、Astra が 10% で課金されるため、10 分の 1 になります。ただし、単価比はタスク全体の費用比ではありません。公表評価で示されたタスクあたりの費用差は、約 5 分の 1、約 7 分の 1 など評価ごとに異なり、推論設定やトークン消費量によって変わります。Astra の提供範囲と料金の詳細は、関連記事『GPT-6 Astra の料金と提供範囲|GPT-5.6 との使い分け』を参照してください。
キャッシュ単価が半額でも総額は半額にならない
旧 Sol から変わった単価はキャッシュ入力だけです。そのため、切り替えによる費用の変化は、入力のうちキャッシュに一致する割合と、出力の多さで決まります。次の試算は、1 リクエストあたり入力 100,000 トークン(うちキャッシュ一致 80,000 トークン)、出力 5,000 トークン(推論トークンを含む)の処理を 1,000 回実行した場合の単価計算です。
| 項目(1,000 回の合計) | GPT-6 Sol | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|---|
| 非キャッシュ入力(2,000 万トークン) | $40 | $40 | $200 |
| キャッシュ入力(8,000 万トークン) | $16 | $8 | $80 |
| 出力(500 万トークン) | $50 | $50 | $250 |
| 合計 | $106 | $98 | $530 |
この試算は、3 モデルの消費トークン量が同じと仮定し、キャッシュ書き込みとツール料金を除外した単価計算であり、実測値ではありません。条件をそろえても、旧 Sol からの削減は約 7.5% にとどまります。キャッシュ入力の単価が半額になっても、総額が半額になるわけではありません。差が大きくなるのは、キャッシュ一致率が高く、出力が少ない処理です。Astra との比較では合計が約 18.5%(約 5.4 分の 1)になりますが、これもトークン消費量が同じという仮定の下での値です。
実際の請求額には、次の条件も加わります。料金条件全体の見方は前述の関連記事で扱っているため、ここでは旧 Sol からの切り替えで影響が出やすい点に絞ります。
- キャッシュ書き込みは両モデルとも $2.50 で、入力単価の 1.25 倍です。書き込みが毎回発生する構成では、キャッシュ入力の値下げの効果が小さくなります。
- 推論トークンは出力トークンとして課金されます。旧 Sol で none を使っていた処理は low 以上へ変更する必要があり、出力側の消費が増える可能性があります。
- 入力が 272K トークンを超えると、リクエスト全体の入力とキャッシュが 2 倍、出力が 1.5 倍で課金されます。GPT-6.1 Sol では入力 $4.00、キャッシュ入力 $0.20、キャッシュ書き込み $5.00、出力 $15.00 です。
- Batch と Flex は Standard の 50%、Fast mode は 2 倍の単価で、データレジデンシー対応のリージョナル処理には 10% が上乗せされます。Web 検索などのツールには、トークンとは別の呼び出し料金がかかります。
ChatGPT と API の提供条件
GPT-6.1 Sol は、ChatGPT の中でも利用できる場所が限られており、API とは契約も課金体系も別です。利用環境ごとに分けて確認します。
| 利用環境 | 提供状況(2026 年 9 月 30 日確認) | 補足 |
|---|---|---|
| 通常の Chat | 未提供 | 発表で、Chat ではまだ利用できないと明記 |
| ChatGPT Work(Web・モバイル) | Plus・Pro・Business・Enterprise・Edu が提供対象 | Enterprise・Edu は管理者が有効化するまでオフ |
| Codex(デスクトップアプリ・CLI) | Plus・Pro・Business・Enterprise・Edu が提供対象 | CLI では gpt-6.1-sol を指定。Codex CLI 0.159.1 で既定モデルに追加 |
| Free・Go | 対象外 | 公開時点の提供対象に含まれない |
| OpenAI API | gpt-6.1-sol で利用可 | Free ティアは非対応。ChatGPT プランとは別の従量課金 |
参考: Models(ChatGPT Learn)
“the plan keeps GPT-6.1 Sol off by default until an administrator enables it.”
(Enterprise・Edu では、管理者が有効化するまで GPT-6.1 Sol は既定でオフになる)
https://learn.chatgpt.com/docs/models
対象プランであっても、すぐに選択できるとは限りません。ChatGPT Learn では、利用できる操作はプラン、クライアント、ワークスペース設定によって異なると案内されています。Enterprise・Edu で表示されない場合は、管理者による有効化とワークスペースのモデル設定を確認してください。提供状況の出典は、発表(Introducing GPT-6.1 Sol)と ChatGPT Learn の changelog です。
推論設定の扱いも ChatGPT と API で異なります。ChatGPT Work と Codex では、推論設定は Light から Ultra までの表示で選び、Max と Ultra は設定によって表示が変わります。ChatGPT の画面で選ぶ推論設定と、API リクエストの reasoning effort は別の設定であり、名称も一致しません。画面での選択が API の処理に反映されることはありません。
速度モードは、公開時点で Standard と Fast が利用でき、Ultrafast は今後の提供予定です。発表では、Codex で標準速度の最大 8 倍の生成速度になる Ultrafast を今後数日のうちに提供するとしています。2026 年 9 月 30 日時点で、API 料金表の Ultrafast 欄に掲載されているのは GPT-6 Astra のみでした。GPT-6.1 Sol の Ultrafast の提供開始後の対応リージョンと料金は、公式情報で確認してください。
API の単価は、ChatGPT の月額料金やクレジットの消費量に置き換えられません。ChatGPT Work と Codex をプラン内で使う場合はモデルごとのクレジットレートで消費され、Codex に API キーでサインインした場合は API 料金の従量課金になります。
GPT-6 Sol から API 移行する際の互換性
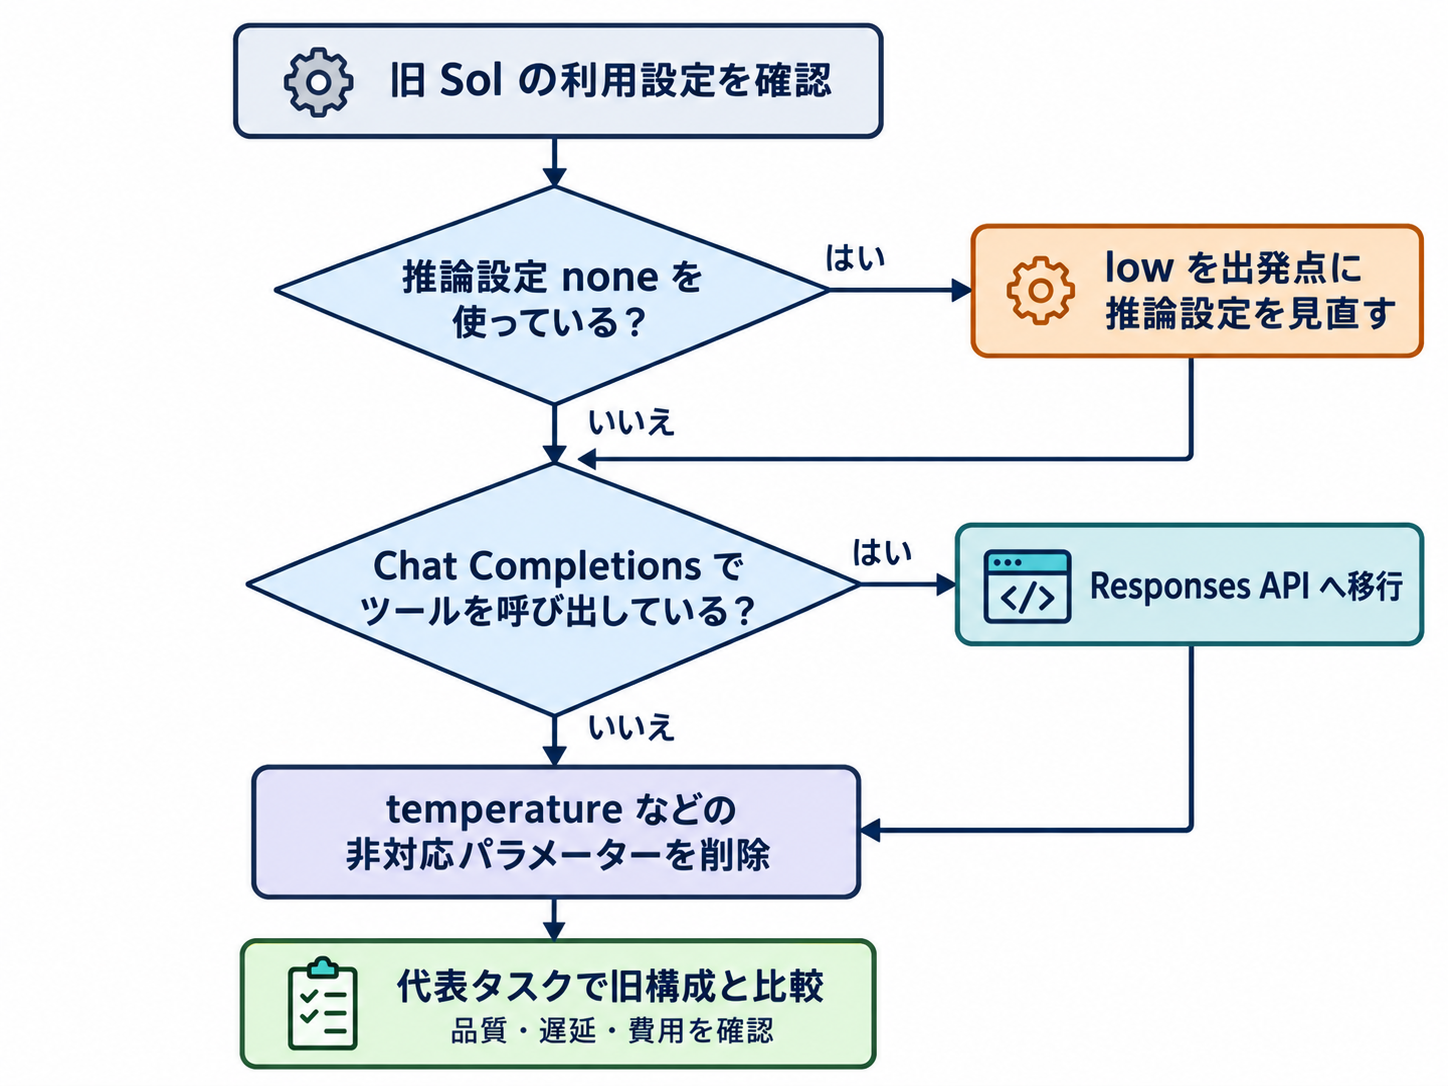
GPT-6.1 Sol へ切り替える前に、現在のリクエストが次のどの条件に当たるかを確認します。変更が必要な項目は、OpenAI のガイド(Using GPT-6)の移行手順に基づいて整理しています。
移行前の確認表
| 現在の設定 | 変更が必要になる条件 | 対応 |
|---|---|---|
モデル ID gpt-6-sol | すべてのリクエスト | gpt-6.1-sol に変更する。変更前の設定一式を記録しておく |
| 推論設定 none | Responses の reasoning.effort または Chat Completions の reasoning_effort に none を指定している | 非対応のため変更が必要。公式案内の low を出発点に、品質・遅延・費用を再評価する |
| 推論設定の指定なし | リクエストで推論設定を省略している | 既定の medium が適用され、旧 Sol と同じ既定値。比較の条件をそろえるため明示指定を推奨 |
| Chat Completions の関数呼び出し | 旧 Sol で reasoning_effort を none にしてツールを呼び出している | Responses API へ移行する。Chat Completions はツールなしのリクエストに限って使える |
| Chat Completions(ツールなし) | ツールを指定していない | 引き続き利用可。none を指定している場合は推論設定の変更が必要 |
temperature・top_p・top_logprobs | 推論設定が none 以外(GPT-6.1 Sol では常に該当) | リクエストから削除する |
| logprobs 関連 | Chat Completions の logprobs、Responses の include にある message.output_text.logprobs | 削除する |
| Fast mode と EU データレジデンシー | EU のリージョナル処理で Fast mode を使っている | GPT-6.1 Sol でも利用不可 |
| 会話途中での推論設定の変更 | リクエストごとに推論設定を切り替えている | configuration_update 入力アイテムの利用を検討する。互換性の制限は公式ガイドで確認 |
推論設定 none からの見直し
GPT-6 Sol は none を含む 6 段階の推論設定に対応していましたが、GPT-6.1 Sol は none と minimal に対応していません。OpenAI のガイドは、現在の実効的な推論設定を維持することを基本とし、none を使っていた場合は low を使うよう案内しています。
none から low への変更は、設定値の置き換えだけでは済みません。none は推論を行わない設定であり、low へ変更すると推論トークンが発生するため、応答時間と出力トークンの消費が増える可能性があります。遅延の要件が厳しい処理では、品質だけでなく完了までの時間も比較の対象にしてください。
推論設定を指定するパラメーターは、API によって書き方が異なります。Responses API は reasoning オブジェクトの effort、Chat Completions は reasoning_effort です。次の例は、公式ガイドの記載に基づいて指定位置を示したもので、当ブログでは実行していません。
Responses API のリクエスト本文(抜粋)
{
  "model": "gpt-6.1-sol",
  "reasoning": { "effort": "low" },
  "input": "..."
}
Chat Completions のリクエスト本文(ツールなし、抜粋)
{
  "model": "gpt-6.1-sol",
  "reasoning_effort": "low",
  "messages": [ ... ]
}
アプリケーション側で推論設定をリクエストごとに切り替えている場合は、プロンプトキャッシュへの影響も確認します。ガイドでは、標準のシングルエージェントのリクエストで configuration_update 入力アイテムを使い、リクエスト単位の reasoning.effort を変えずにキャッシュ対象のプロンプト先頭を保つ方法が案内されています。
Chat Completions のツール呼び出しは Responses へ
旧 Sol では、Chat Completions で関数呼び出しを使える条件が推論設定 none に限られていました。
参考: GPT-6 Sol Model(OpenAI API ドキュメント)
“Chat Completions supports function calling only with reasoning_effort set to none.”
(Chat Completions は、reasoning_effort が none の場合にのみ関数呼び出しをサポートする)
https://developers.openai.com/api/docs/models/gpt-6-sol
GPT-6.1 Sol は none に対応せず、Chat Completions ではツールを呼び出せないため、この構成は両方の条件で使えなくなります。旧 Sol の Chat Completions で関数呼び出しを使っている処理は、モデル ID を変えるだけでは移行できず、Responses API への移行が必要です。Responses API はリクエストとレスポンスの構造が Chat Completions と異なるため、ツール呼び出しの受け渡し部分も改修の対象になります。移行方法は OpenAI の Responses API の移行ガイドで確認してください。
推論ありで使えないパラメーター
推論設定が none 以外のときは、サンプリング関連と logprobs 関連の一部のパラメーターを使えません。GPT-6.1 Sol は常に推論ありで動作するため、旧 Sol の none 運用でこれらを指定していた処理は、必ず見直しの対象になります。
参考: Using GPT-6(OpenAI API ドキュメント)
“When reasoning effort is not none, remove temperature, top_p, and top_logprobs.”
(推論設定が none 以外の場合は、temperature、top_p、top_logprobs を削除する)
https://developers.openai.com/api/docs/guides/latest-model
ガイドでは、Chat Completions の logprobs と、Responses の include に指定した message.output_text.logprobs も削除対象とされています。temperature で出力の揺れを抑えていた処理は、同じ入力を複数回実行して結果のばらつきを確認し、その結果を合格条件に含めることをおすすめします。
切り替え前後の確認手順|旧 Sol との比較と合格基準
ここでは、旧 Sol から GPT-6.1 Sol へ切り替える際の確認手順を示します。当ブログでの実測ではなく、これから試す際の進め方としての提案です。モデル選定の一般的な評価方法は、前述の関連記事『GPT-6 Sol・Luna の違い』で扱っています。
ソースコード、設定ファイル、リクエストログから、モデル ID、使用している API(Responses / Chat Completions)、推論設定、ツール、temperature などのパラメーター、処理モード(Standard・Batch・Flex・Fast)、データレジデンシーを洗い出します。前述の確認表のどの行に当たるかを処理ごとに記録し、旧構成の設定一式を保存しておきます。
実際に旧 Sol で処理している業務から代表タスクを選び、正解、制約、合格条件を実行前に文書化します。機密情報や認証情報はマスキングしてから評価用データにします。
- 匿名化したファイアウォールログから、指定した条件のイベントを抽出する
- ベンダーの手順書 PDF から、前提条件と切り戻し手順を抜き出す
- 既存の PowerShell スクリプトを、指定した要件に合わせて修正する
確認表で必要になった変更を適用し、旧構成と新構成で入力、ツール、採点条件をそろえて実行します。推論設定を変えた場合は、旧構成 none、新構成 low のように差分を記録し、モデルの違いと設定の違いを区別できるようにします。出力の揺れを確認するため、1 件につき複数回実行します。
次の項目を処理ごとに記録し、手順 2 で決めた合格条件と照合します。
- 事実の誤り、必要な情報の欠落、指示した出力形式への違反の件数
- ツール呼び出しの失敗(呼び出し漏れ、引数の誤り、結果の取り違え)の件数
- 完了までの時間、再試行の回数、人による修正時間
- レスポンスの
usageに記録された入力、キャッシュ入力、キャッシュ書き込み、出力のトークン数と、それに基づく費用
合格基準の例としては、事実の誤りと欠落が 0 件、ツール呼び出しの失敗が 0 件、完了までの時間が業務上の許容範囲内、合格までの費用が旧構成と同等以下、といった形で、切り替え前に数値で決めておくことをおすすめします。
合格した処理から順に、一部のジョブや利用者に限定して切り替えます。品質や費用が基準を外れた場合に以前の構成へ戻せるよう、旧構成のモデル ID、API、推論設定、パラメーターを保存します。Chat Completions から Responses API へ移行した処理は、設定の変更だけでは元に戻せないため、旧 API の入出力やツール呼び出しの処理を含む実装、または切り戻せるコードの版も保存し、戻す手順を事前に確認しておきます。
切り戻しの設計では、GPT-6 Sol を切り戻し先として恒久的に使える前提を置かないことが重要です。今回確認した公式ページには、旧 Sol の提供終了時期は記載されていませんが、提供の継続が保証されているわけでもありません。代表タスクで GPT-6.1 Sol が合格条件を満たさなかった処理は、Astra を割り当てたまま残す判断も考えられます。いずれも合格条件に基づいて判断することをおすすめします。
評価に使ったデータと合格条件は、切り替え後も残しておくと、次のモデル更新や料金改定の際に同じ基準で再評価できます。
まとめ
GPT-6.1 Sol は、GPT-6 Sol の標準単価を据え置いたままキャッシュ入力を半額にし、OpenAI の評価では Astra に近い性能を示したモデルです。一方で、推論設定 none と Chat Completions でのツール呼び出しに対応していないため、旧 Sol の構成によってはモデル ID の変更だけでは移行できません。切り替えは、互換性の確認と代表タスクでの比較を経て判断することが出発点になります。
- GPT-6 Sol のアップグレード版として公開された Sol 系の新モデル
- 標準単価は据え置きで、キャッシュ入力だけが $0.10 に半減
- Astra 比の 5 分の 1 は標準入出力の単価比で、タスク費用の比ではない。
- ChatGPT では Work と Codex が対象で、通常の Chat は未提供
- 推論設定 none と Chat Completions でのツール呼び出しは非対応
- 旧 Sol の none 運用は、low を起点に品質・遅延・費用を再評価する。
- 切り替えは合格条件を先に決め、戻せる状態を保って小さく始める。
以上、最後までお読みいただきありがとうございました。