はじめに
Google は 2026 年 10 月 13 日(米国時間)、Gemini 4 Argon の一般提供を開始しました。9 月 30 日の発表時点では Fairwind Program を通じた一部の組織への限定提供でしたが、現在は Gemini API の有料ティア、Gemini アプリ、Google Antigravity、企業向けの Gemini for business などから利用できます。
一方で、モデル選定に必要な判断材料は、Google の発表だけではそろいません。第三者評価機関の Artificial Analysis は一般提供前の 9 月 30 日に評価結果を公表しており、総合スコア、ハルシネーション率、業務自動化、ベンチマークのタスクあたり費用について、Google 公式とは別の視点の数値を示しています。本記事では、2026 年 10 月 14 日時点で確認した公式情報と第三者評価をもとに、利用条件、評価の読み方、GPT-6 Astra と比較した実効コスト、業務での利用判断を整理します。
- Gemini アプリ、Gemini API、AI Studio / Antigravity での試用、Fairwind Program の利用条件の違い
- 導入価格と 2026 年 12 月 1 日以降の通常価格、キャッシュと thinking 設定の扱い
- Artificial Analysis の総合 53 点を、推論設定と評価時点を踏まえて読む方法
- ハルシネーション率 15% と正答率 50% がそれぞれ示すこと
- 単価、トークン消費量、タスクあたり費用で見た GPT-6 Astra との違い
- 情シス・インフラ・開発業務で導入前に確認すべき事項
結論: 誤答は少ないが、正答率は Astra(Max)より低い
Gemini 4 Argon(High)は Artificial Analysis の総合評価で GPT-6 Astra(Max)と同じ 53 点です。知識ベンチマークでは、正答しなかった問題で誤答する割合(ハルシネーション率)が 15% と低い一方、正答率は 50% で Astra(Max)の 63% を下回ります。トークン単価は Astra(Max)より安いものの、消費する出力トークンは約 2.3 倍で、12 月 1 日以降の通常価格では、ベンチマークのタスクあたり費用が Astra(Max)を上回る試算になります。
Gemini 4 Argon が一般提供開始|利用条件と API 料金
Argon は 10 月 13 日から世界的に提供が始まりました。ただし、利用できる経路と必要な契約は製品ごとに異なり、特に Gemini アプリと Gemini API の扱いは混同しやすい部分です。
利用経路ごとの提供条件
| 利用経路 | 必要な契約・条件 | 補足 |
|---|---|---|
| Gemini アプリ、検索の AI モード | Google AI Ultra または Google AI Pro | 一般ユーザー向け |
| Gemini API(Google AI Studio、Android Studio から利用) | Gemini API の有料ティア | トークン単位の従量課金。Free tier と Google AI Pro プランでは利用不可 |
| Google AI Studio、Google Antigravity での試用 | Google AI Ultra | API の有料ティアとは別の、サブスクリプションによる試用経路 |
| 企業向け | Gemini for business、Gemini API、Google Antigravity | 対象エディションと利用上限は本記事では未確認 |
| Fairwind Program | 審査を通過したサイバー防御組織 | 通常の一般提供とは別枠(後述) |
出典: Google「Gemini 4 Argon: Built to solve your hardest problems」、Gemini Developer API pricing(2026 年 10 月 14 日確認)
Gemini アプリでは Google AI Pro が対象になっていますが、開発者向けの Gemini API では Google AI Pro プランも Free tier も対象外です。アプリやサービスに組み込む場合は、有料ティアの請求設定が前提になります。
参考: Gemini Developer API pricing
“Gemini 4 Argon is not available on the Free tier or on the Google AI Pro plan.”
(Gemini 4 Argon は、Free tier と Google AI Pro プランでは利用できない)
https://ai.google.dev/gemini-api/docs/pricing
Gemini API のモデル仕様と料金
Gemini API のモデルページでは、Argon は Stable(安定版)のモデルとして掲載され、モデル ID は gemini-4-argon です。入力はテキスト、画像、動画、音声、PDF に対応し、出力はテキストのみです。Model Card によると、知識カットオフは 2026 年 3 月です。料金表では、限定提供の時点で未公表だった導入期間の終了日と処理モード別の単価が明記されました。
| 処理モード(100 万トークンあたり) | 2026 年 11 月 30 日まで(導入価格) | 2026 年 12 月 1 日以降(通常価格) |
|---|---|---|
| Standard 入力 / 出力 | $2.00 / $10.00 | $4.00 / $20.00 |
| Standard キャッシュ入力 | $0.10 | $0.20 |
| Batch・Flex 入力 / 出力 | $1.00 / $5.00 | $2.00 / $10.00 |
| Priority 入力 / 出力 | $3.60 / $18.00 | $7.20 / $36.00 |
出力料金には thinking トークンが含まれます。導入価格は一般向けの Argon に適用されるもので、Fairwind Program 向けの料金は本記事の確認範囲では公表されていません。
費用の見積もりに影響する制約は次のとおりです。
- キャッシュは暗黙的キャッシュのみで、明示的キャッシュ(キャッシュを作成・管理する方式)には対応していません。暗黙的キャッシュは入力が 4,096 トークン以上の場合に対象となり、共通する内容をプロンプトの先頭に置き、短い間隔で送るほどヒットしやすいとされています。
- Google 検索によるグラウンディングは、リクエスト数ではなく、モデルが実行した検索クエリの数で課金されます。1 回の API リクエストで複数の検索クエリが実行される場合があり、Gemini 3 以降のモデル全体で月 5,000 件の無料枠を超えると 1,000 件あたり $14 です。
temperature、top_p、top_kは、Gemini 3.6 Flash の公開時に、同モデルと以降のすべての Gemini モデルで非推奨とされ、API は指定値を無視します。将来のモデル世代ではエラーになると案内されているため、既存のアプリから移行する場合はリクエストから削除しておくことをおすすめします。
出典: Context caching、Grounding with Google Search、What’s new in Gemini 3.6 Flash(2026 年 10 月 14 日確認)
1M トークンは入力と出力を合わせた上限
旧版の記事では、発表時点の情報から「出力上限が 1M トークン」と説明していました。公開されたドキュメントでは、1,048,576 トークンのコンテキストウィンドウを入力、thinking、出力で共有する仕組みと説明されています。
1 回の呼び出しの出力上限は既定で 65,536 トークンです。それを超えて生成するには、Interactions API でバックグラウンド実行(background: true)を有効にし、max_output_tokens を 65,536 より大きく設定する long decode を使います。上限は 1,048,576 から入力トークン数を引いた値です。
推論の量は thinking_level で low、medium、high から選べ、既定は medium です。後述の第三者評価は high での結果のため、既定の medium や low で使う場合の性能やトークン消費量は、評価結果と一致するとは限りません。
long decode では、継続のたびにそれまでの生成内容が入力として再送され、すべての回で課金されます。再送分は暗黙的キャッシュで割り引かれますが、長い推論は出力だけでなく入力側の課金も増やします。
参考: Long decode(Gemini API ドキュメント)
“You pay for every token in every hop, including hops that contain only thinking.”
(thinking のみを含む回も含め、すべての回のすべてのトークンに課金される)
https://ai.google.dev/gemini-api/docs/long-decode
Fairwind Program は通常の一般提供とは別枠
Fairwind Program は、審査を通過した政府機関、重要インフラ事業者、基盤技術を提供する組織に、サイバー領域のガードレールを外した Argon を提供する制度です。Google は一般提供と同時に、参加組織を数百規模で追加していくと発表しました。参加組織には、利用者をセキュリティチームに限定することやアクセスの記録などが求められ、Gemini Enterprise 上で直接利用する場合の zero data retention(データ保持なし)も、この制度の FAQ での説明です。一般提供の Argon とはセーフガードと利用条件が異なるため、一般の経路で使う場合は契約ごとの利用規約とデータの扱いを確認してください。Flash Cyber を含む制度の位置づけは『Gemini 3.8 Flash の料金と使い分け|Cyber は限定提供』で整理しています。
Gemini 4 Argon の第三者評価|総合 53 点の位置づけ
Artificial Analysis は、各社のモデルを同じ評価環境で独自に計測している第三者の評価機関です。総合指標の Intelligence Index(v4.3.2)は、エージェント型の業務、コーディング、科学的推論、知識とハルシネーション、長文読解など 10 種類の評価で構成されています。
評価時点と推論設定の前提
評価レポートの公開日は 2026 年 9 月 30 日で、一般提供の開始より前です。レポートは Argon について、一部の利用者に展開中で一般には提供されていないと記載しており、導入価格の終了日も未確定の扱いでした。
本記事で紹介する Artificial Analysis の数値は、一般提供前に公表された評価結果です。一般提供後のモデルで改めて計測した結果ではありません。
推論設定は、Argon が High(評価時点で利用できた最も高い設定)、比較対象の GPT-6 Astra が Max です。以降の比較は、すべてこの組み合わせを前提としています。
GPT-6 Astra(Max)との主な項目の比較
総合スコアはともに 53 点で同点ですが、内訳では得意分野が分かれています。業務での選定に関係の深い項目を抜粋します。
| 評価項目(測る内容) | Gemini 4 Argon(High) | GPT-6 Astra(Max) |
|---|---|---|
| Intelligence Index(総合) | 53 | 53 |
| AutomationBench-AA(SaaS をまたぐ業務自動化) | 78% | 68% |
| GDPval-AA v2.1(実務タスクの成果物、Elo) | 1624 | 1572 |
| Terminal-Bench 4.0(ターミナル操作を伴う作業) | 57% | 59% |
| AA-Briefcase v1.1(ナレッジワークの成果物、Elo) | 1488 | 1571 |
| GDP.pdf(長い業務文書の読解) | 22% | 31% |
| AA-Omniscience(知識の信頼性) | 42 | 43 |
出典: Artificial Analysis「Gemini 4 Argon (High) vs. GPT-6 Astra (Max)」(2026 年 10 月 14 日確認)。全 10 項目の値は出典ページで確認できます。
Argon が上回るのは業務自動化と実務タスクの成果物です。一方、長い業務文書の読解(GDP.pdf)と、成果物の分析品質・体裁まで評価する AA-Briefcase では Astra(Max)が上回っています。AA-Briefcase について評価レポートは、Argon の採点基準の達成率は同機関の計測で最高だったものの、分析品質と体裁の評価が低かったと説明しています。総合点が同じでも、文書の読解や体裁の整った成果物を重視する業務では、Astra(Max)が有利な結果も出ています。
順位の扱いと Google 公式の性能表との違い
評価レポートの時点で、Argon(High)の 53 点は Astra(Max)と並ぶ上位の値でした。その後も評価対象のモデルは増えており、10 月 14 日時点では推論設定の違いを含めて 53 点を上回るエントリーがあります。順位は変動するため、引用する際は確認日を併記することをおすすめします。
Google の公式性能表は 19 項目で Argon と他社モデルを比較していますが、評価方法の資料によると、他社モデルの値は原則として各社の自己申告値や公開リーダーボードから取得したものです。掲載する指標と比較相手を Google が選んでいるため、同一環境で全モデルを計測した第三者評価とは性格が異なります。
ハルシネーション率 15% と業務自動化の評価
第三者評価で Argon の特徴が最も表れているのが、知識の信頼性を測る AA-Omniscience と、業務自動化を測る AutomationBench-AA です。どちらも数字だけを取り出すと誤解しやすいため、指標の定義から確認します。
ハルシネーション率と正答率は別の指標
AA-Omniscience は、6 つの分野、42 のトピックにわたる 6,000 問で、事実知識と「分からないときに回答を控えられるか」を測る評価です。3 つの指標は次のように定義されています。
- 正答率(Accuracy)
-
回答したかどうかに関係なく、全問題のうち正答した割合です。
- ハルシネーション率(Hallucination Rate)
-
正答しなかった応答(誤答、部分回答、未回答)のうち、誤答が占める割合です。全回答に占める誤答の割合ではありません。
- AA-Omniscience Index
-
正答を加点し、ハルシネーションを減点し、回答の辞退は減点しない総合指標です。-100 から 100 の範囲で、0 は正答と誤答が同数であることを示します。
参考: Artificial Analysis「AA-Omniscience」
“the proportion of incorrect answers out of all non-correct responses”
(正答しなかったすべての応答のうち、誤答が占める割合)
https://artificialanalysis.ai/evaluations/omniscience
| AA-Omniscience | Gemini 4 Argon(High) | GPT-6 Astra(Max) | GPT-6.1 Sol(Max) |
|---|---|---|---|
| ハルシネーション率(低いほど良い) | 15% | 51% | 54% |
| 正答率(高いほど良い) | 50% | 63% | 未掲載 |
| Omniscience Index(高いほど良い) | 42 | 43 | 42 |
出典: Artificial Analysis の評価レポート(2026 年 9 月 30 日)。Sol の正答率はレポートに記載がないため未掲載としています。
Artificial Analysis は、Argon の 15% を Intelligence Index が 45 点以上のモデルの中で最も低いハルシネーション率とし、答えが分からないときに推測で誤答するより、分からないと認める可能性が高いと説明しています。一方で、正答率は Astra(Max)より 13 ポイント低く、正答と誤答を総合した Omniscience Index は 42 対 43 でほぼ並んでいます。
100 問に換算した回答の傾向
定義に沿って、公表値を 100 問あたりに換算すると違いが分かりやすくなります。次の表は公表された正答率とハルシネーション率から算出した編集部の概算で、Artificial Analysis が公表した内訳ではありません。
| 100 問あたり(概算) | Gemini 4 Argon(High) | GPT-6 Astra(Max) |
|---|---|---|
| 正答 | 50 問 | 63 問 |
| 正答しなかった応答 | 50 問 | 37 問 |
| うち誤答(50 × 15%、37 × 51%) | 約 8 問 | 約 19 問 |
| うち部分回答または未回答(両者の内訳は非公表) | 約 42 問 | 約 18 問 |
Argon は誤答を約 8 問に抑えていますが、正答できなかった残りの約 42 問は部分回答か未回答です。公表された正答率とハルシネーション率だけでは、そのうち何問で回答を控えたのかは分かりません。Astra(Max)は正答が多い一方、誤答も約 19 問あります。ハルシネーション率が低いことは「最も正確」という意味ではなく、「正答できなかったときに誤答が占める割合が低い」という性質です。
業務に当てはめると、誤った断定が後工程へ流れるリスクを下げやすい半面、正答が得られなかった部分は人が調べ直す必要があります。なお、正答率 50% は AA-Omniscience という知識ベンチマークでの結果で、通常の業務質問に対する正答率を示すものではありません。事実確認や人によるレビューは、引き続き前提として残ります。
AutomationBench-AA の約 78% と Google 公式の 51.3% は別の数値
AutomationBench は、Zapier が公開した業務自動化のベンチマークです。Gmail、Google Sheets、Slack、Salesforce、Zendesk、Jira、HubSpot などを模した環境で、エージェントが API を自ら探し、業務ルールに従って複数のシステムへ正しいデータを書き込めるかを評価します。Artificial Analysis 版の AutomationBench-AA では、Argon(High)が 77.5% で首位、Claude Sonnet 5.5(Max)が 71.8% で続き、GPT-6 Astra(Max)は 68% です。
Google の公式性能表にも AutomationBench の 51.3% という値がありますが、両者は同じ数値として比較できません。
| 項目 | Google 公式の AutomationBench | Artificial Analysis の AutomationBench-AA |
|---|---|---|
| Argon の値 | 51.3% | 77.5%(High) |
| 評価主体と出典 | Zapier の公式リーダーボード(非公開セット)の値を Google が掲載 | Artificial Analysis が独自に計測 |
| 指標 | Zapier のリーダーボードは、タスクのすべての目標を達成した割合を報告 | 各タスクの目標の達成割合の平均。禁止事項に違反したタスクは 0 点 |
出典: Artificial Analysis「AutomationBench-AA」、Google DeepMind の Gemini 4 Argon 性能表(2026 年 10 月 14 日確認)
AutomationBench-AA は、目標の一部を達成すれば部分点が入る一方、禁止事項(ガードレール)に違反するとそのタスクは 0 点になる採点です。タスク全体を完了できた割合ではない点に注意してください。
参考: Artificial Analysis「AutomationBench-AA」
“where any task with a guardrail violation scores zero”
(ガードレールに違反したタスクは 0 点となる)
https://artificialanalysis.ai/evaluations/automationbench-aa
評価環境は模擬された SaaS で、主な対象は営業、人事、財務、サポートなどの業務フローです。この結果は、ネットワーク機器の設定変更やクラウド基盤の操作といったインフラ運用作業を、安全に自動実行できることを示すものではありません。運用自動化に使う場合の確認観点は後述します。
GPT-6 Astra と比較したトークン消費量と実効コスト
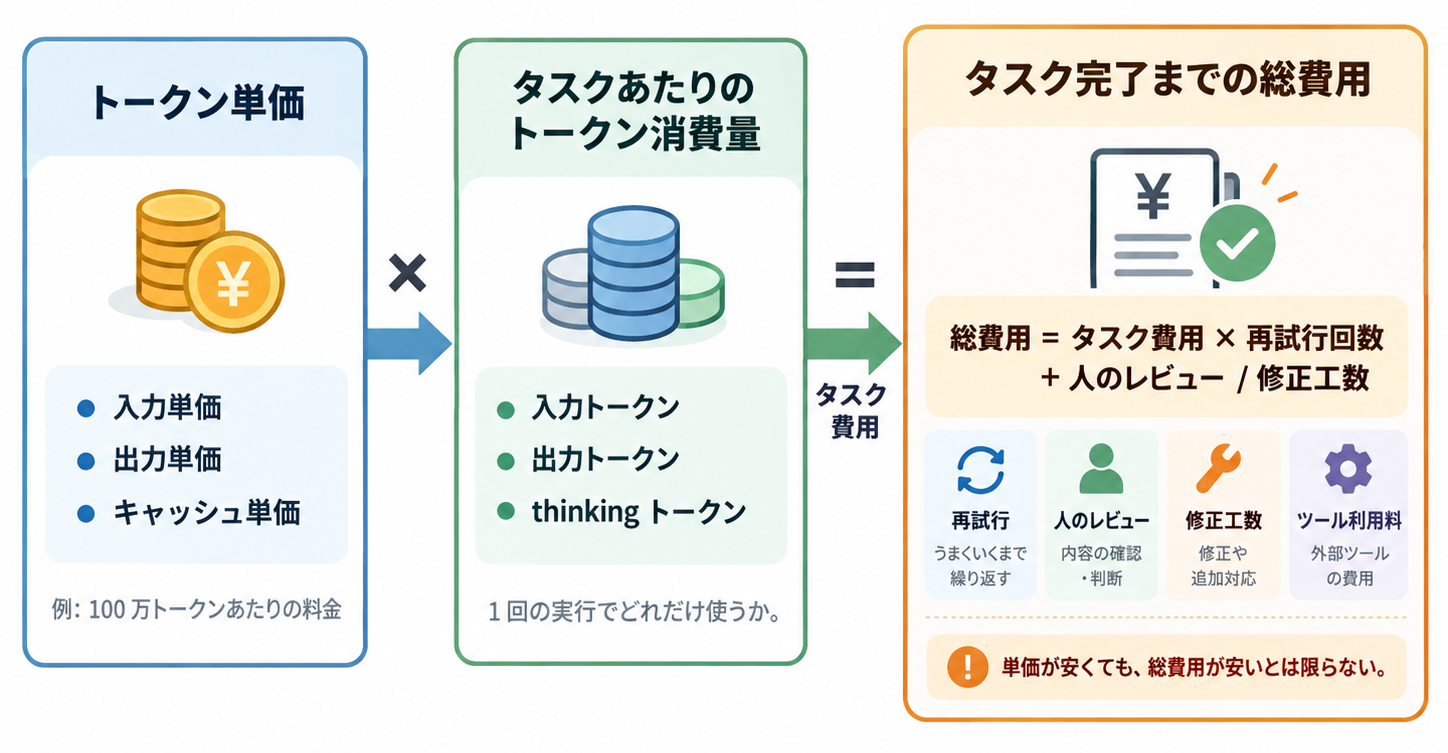
モデルの費用は、トークン単価だけでは決まりません。本記事では、次の 2 つの費用を区別して扱います。
- ベンチマークのタスクあたり費用
-
トークン単価 × 評価タスクで消費したトークン数です。Artificial Analysis が Intelligence Index の評価で算出した平均値で、モデル同士を同じ条件で比べる目安になります。
- タスク完了までの総費用
-
実際の業務で、再試行、ツール呼び出し、人によるレビューと修正の工数まで含めた費用です。自社のタスクで計測する必要があります。
出力トークンは約 2.3 倍、そのうち推論は約 36,000
| Intelligence Index のタスクあたり | Gemini 4 Argon(High) | GPT-6 Astra(Max) |
|---|---|---|
| 入力単価 / 出力単価(100 万トークン) | $2.00 / $10.00(導入価格) | $10.00 / $50.00 |
| キャッシュ入力の単価 | $0.10 | $1.00 |
| 出力トークン数 | 約 62,000 | 約 27,000 |
| うち推論トークン数 | 約 36,000 | 約 17,000 |
| ベンチマークのタスクあたり費用 | $1.99 | $3.26 |
出典: Artificial Analysis の比較ページ(2026 年 10 月 14 日確認)。単価は Artificial Analysis が費用計算に用いた値です。
出力トークン数には推論(thinking)に使ったトークンが含まれます。約 2.3 倍という差は、利用者に表示される回答が 2.3 倍長いという意味ではありません。Argon の約 62,000 のうち約 36,000 が推論トークンで、推論トークンも出力単価で課金されます。
参考: Artificial Analysis「Gemini 4 Argon: Google is back as one of the top three labs in intelligence achieved」
“This cost efficiency is driven by lower token prices, rather than reduced token use”
(このコスト効率は、トークン消費の削減ではなく、トークン単価の低さによるもの)
https://artificialanalysis.ai/articles/gemini-4-argon-google-top-three-labs
なお、Argon の $1.99 のうち出力分は約 $0.62 で、残りは入力とキャッシュの費用です(編集部の概算)。作業の途中経過が繰り返し入力されるエージェント型のタスクでは、出力だけでなく入力側の単価とキャッシュの効き方も費用を左右します。
通常価格ではタスクあたり費用が Astra(Max)を上回る
Argon の単価は、導入価格では Astra(Max)の 5 分の 1 ですが、2026 年 12 月 1 日からはすべての単価が 2 倍になり、Astra(Max)の 5 分の 2 になります。Artificial Analysis は、同じトークン消費条件で通常価格を適用した場合のタスクあたり費用を $3.98 と示しています。
| 比較項目 | 2026 年 11 月 30 日まで(導入価格) | 2026 年 12 月 1 日以降(通常価格) |
|---|---|---|
| Argon の単価(Astra(Max)比) | 5 分の 1 | 5 分の 2 |
| Gemini 4 Argon(High)のタスクあたり費用 | $1.99 | $3.98 |
| GPT-6 Astra(Max)のタスクあたり費用 | $3.26 | $3.26 |
| Argon ÷ Astra(Max) | 約 0.6 倍 | 約 1.2 倍 |
通常価格でも単価は Astra(Max)の 5 分の 2 にとどまりますが、出力トークンが約 2.3 倍のため、ベンチマークのタスクあたり費用は逆転します。この比較は、Artificial Analysis が同じ評価時点で計測したトークン消費量を前提にした試算で、Astra(Max)の単価が据え置かれることも前提にしています。すべての業務で Argon の費用が高くなることを意味するものではなく、自社のタスクでトークン消費量が異なれば結果も変わります。導入価格の期間に計測した費用だけで年間予算を組むと、12 月以降に不足する可能性があります。
推論設定を変えると比較結果も変わる
上記は Argon(High)と Astra(Max)の比較です。比較相手の推論設定を変えると、スコアと費用の関係は大きく変わります。
| モデル(推論設定) | Intelligence Index | ベンチマークのタスクあたり費用 |
|---|---|---|
| Gemini 4 Argon(High) | 53 | $1.99(通常価格では $3.98) |
| GPT-6 Astra(Max) | 53 | $3.26 |
| GPT-6 Astra(Xhigh) | 52 | $2.31 |
| GPT-6 Astra(High) | 51 | $1.73 |
| GPT-6.1 Sol(Max) | 52 | $0.72 |
出典: Artificial Analysis LLM Leaderboard(2026 年 10 月 14 日確認)
Astra(High)は総合点が 2 点低い代わりに、タスクあたり費用は導入価格の Argon(High)より安く、通常価格の Argon(High)の半分以下です。AA-Omniscience では、Astra(High)の Omniscience Index は 44 で、Astra(Max)の 43 を上回っています。Argon 側も、API の既定は medium であり、high 以外の設定での第三者評価は本記事の確認範囲では見当たりません。「Argon は Astra より安い」「同等の性能」といった比較は、どの推論設定同士を比べたかを明示しないと成り立ちません。GPT-6 Astra の料金体系と提供範囲は『GPT-6 Astra の料金と提供範囲|GPT-5.6 との使い分け』で整理しています。
自社タスクでの費用試算
自社の業務で見積もる際は、代表的なタスクの入力・出力トークン数を実測し、両方の価格で試算します。次の表は条件を固定した試算例で、実測値ではありません。再試行、グラウンディングなどの追加料金、人の工数は含めていないため、タスク完了までの総費用はこれより大きくなります。
| 試算の条件(Standard) | 導入価格 | 通常価格 |
|---|---|---|
| 1 タスク(入力 100,000 / 出力 20,000 トークン) | $0.40 | $0.80 |
| 上記のタスクを月 1,000 回 | $400 | $800 |
| 上記の入力のうち 80% が暗黙的キャッシュに当たった場合 | 約 $0.25 | 約 $0.50 |
| 出力が 200,000 トークンに増えた場合(入力は 100,000) | $2.20 | $4.40 |
暗黙的キャッシュのヒット率は利用者側で保証できないため、キャッシュなしの費用も併せて見積もることをおすすめします。推論が長くなると出力トークンが増え、費用は大きく変わります。本番投入の前に、thinking_level の設定ごとに、完了率とトークン消費量を記録して比較することをおすすめします。
Gemini 4 Argon はどのような業務に向いているか
ここまでの第三者評価から、情シス・インフラ・開発の業務への適性を考えます。以下は公表されたベンチマークをもとにした編集部の考察であり、筆者が Argon を業務で検証した結果ではありません。ベンチマークで直接証明できない部分は「実環境で確認すべきこと」として分けています。
用途別の期待できる点と確認事項
| 用途 | 第三者評価から期待できる点 | 実環境で確認すべきこと |
|---|---|---|
| ログや技術文書の分析 | 正答できなかったときに誤答する割合が低い傾向は、誤った原因の断定を減らすことにつながる可能性がある | 長文の業務文書の読解(GDP.pdf)では Astra(Max)を下回っているため、自社のログ量・文書形式で読み落としを確認する |
| 運用手順書や調査報告書の作成 | 実務タスクの成果物を比べる GDPval-AA では Astra(Max)を上回る | AA-Briefcase では分析品質と体裁の評価が低いため、社内の書式や記載粒度に合うかをレビューする |
| 複数工程を伴う業務自動化 | AutomationBench-AA で首位。SaaS をまたぐ定型業務フローとの相性が期待できる | 評価は模擬 SaaS 環境の結果のため、実際の API、権限、例外データでの完了率を測る |
| ソースコードや設定内容のレビュー | ターミナル操作を伴う作業(Terminal-Bench 4.0)は Astra(Max)とほぼ同水準 | 機器設定やスクリプトのレビューは、既知の不備を含むサンプルで検出率と誤検出を確認する |
| セキュリティ調査やインシデント対応の補助 | 誤答の割合が低い傾向は、調査メモの誤情報を減らす方向に働く可能性がある | 知識ベンチマークの正答率は 50% のため、CVE や修正版などの事実は一次情報で裏取りする。一般提供版にはサイバー領域のガードレールがある |
業務自動化で確認すべき観点
エージェントに作業を任せる場合は、回答の正しさに加えて、誤った操作をしたときの影響を限定できるかが重要になります。AutomationBench-AA が禁止事項の違反を 0 点として扱うように、実運用でも「完了率」と「やってはいけない操作をしないこと」を分けて評価する必要があります。
| 観点 | 確認する内容 |
|---|---|
| 権限 | エージェントに与えるファイル、コマンド、外部システムへの権限を、タスクに必要な範囲へ絞る |
| 承認 | 本番環境の変更、外部への送信、削除などの取り消せない操作の前に、人の承認を挟む |
| ログ | 入力、ツール呼び出し、変更内容を記録し、後から操作を追跡できるようにする |
| 停止 | 想定外の挙動を検知したときに処理を止める手段と、変更を切り戻す手順を用意する |
| タスク完了率 | 部分的な達成ではなく、最後まで正しく完了した割合と、禁止事項の違反件数を分けて記録する |
| 総費用 | 再試行、ツール呼び出し、人によるレビューと修正の工数を含めて、通常価格で試算する |
Google は、間接的なプロンプトインジェクションへの耐性や、取り返しのつかない操作の前に人の確認を求める学習を Argon の安全対策として挙げています。これらは Google の公表内容であり、耐性の向上はプロンプトインジェクションを防げる保証ではないため、上記の権限分離や承認は引き続き必要です。Google Cloud 上でエージェントの外向き通信を許可制にする仕組みは、『Gemini エージェントとは|企業向け機能と Agent Gateway の注意点』で解説しています。
まとめ
Gemini 4 Argon は 2026 年 10 月 13 日に一般提供が始まり、第三者評価では GPT-6 Astra(Max)と同じ総合 53 点を得ています。ただし、その中身は「誤答の割合は低いが正答率も低い」という知識面の性質と、トークン消費の多さを単価の安さで補う費用構造です。導入を判断する際は、推論設定をそろえた比較と、通常価格を前提にしたタスク完了までの総費用の試算をおすすめします。
- API は有料ティアのみで、Free tier と AI Pro プランは対象外です。
- Gemini アプリでは AI Ultra と AI Pro の契約者が利用できます。
- 第三者評価は一般提供前の結果で、Argon は High 設定での値です。
- ハルシネーション率 15% は、非正答に占める誤答の少なさを示します。
- 知識ベンチマークの正答率は 50% で、事実確認は引き続き必要です。
- 出力トークンは Astra(Max)の約 2.3 倍で、推論分を多く含みます。
- 通常価格の単価は 5 分の 2 でも、タスクあたり費用は逆転します。
以上、最後までお読みいただきありがとうございました。