はじめに
Google は 2026 年 9 月 23 日(日本時間 9 月 24 日)、テキストから音声を生成する新しいモデルとして Gemini 3.8 Flash TTS と Gemini 3.8 Flash-Lite TTS を発表しました。自然言語による声の設計や、2 人の話者による台本の演出などが紹介されています。
一方で、社内研修や操作説明の音声化を検討する立場では、どちらのモデルを試すか、専門用語を含む日本語を正しく読めるか、費用と業務データの扱いはどうなるかが判断材料になります。本記事では独自検証は行わず、公式発表、Gemini API のドキュメント、料金表、利用規約をもとに、採用判断に必要な情報を整理します。
- Gemini 3.8 TTS と Live API、通常の Gemini モデルとの違い
- Flash TTS と Flash-Lite TTS の推奨用途と対応機能の違い
- 提供開始済みのサービスと今後提供予定のサービスの区別
- 2026 年末までと 2027 年以降の料金、10 分の音声の概算
- 無料枠と有料利用でのデータの扱いの違い
- 旧 TTS モデルから移行する際の変更点
- 日本語の業務用ナレーションを採用する前の確認表と評価用原稿
結論: 2 モデルとも日本語に対応し、同じ原稿で比較できる
Gemini 3.8 TTS は、入力テキストを逐語的に読み上げる音声生成専用のモデルです。表現力と難しい発音への対応を重視した Flash TTS と、大量生成とコスト効率を重視した Flash-Lite TTS の 2 種類があり、日本語、声の設計、声の複製は両モデルで対応しています。
2 モデルは API の形式が共通で、モデル名を変えるだけで切り替えられます。日本語の説明音声では、公式の推奨用途を出発点に、Flash-Lite TTS と Flash TTS を同じ短い原稿で生成し、読み間違い、再生成時のばらつき、費用、データの扱いを確認してから採用を判断することをおすすめします。
Gemini 3.8 TTS の概要と 2 モデルの選び方
まず TTS が担う範囲を確認し、そのうえで 2 モデルの違いと選び方を整理します。
TTS と Live API・通常の Gemini との違い
Gemini 3.8 TTS の入力はテキストのみ、出力は音声のみです。音声の聞き取りや会話の応答文の生成は行わないため、用途に応じて他のモデルと役割を分けて考える必要があります。
- TTS(Gemini 3.8 Flash TTS/Flash-Lite TTS)
-
テキストを受け取り、原稿どおりに読み上げた音声を返します。研修ナレーションやオーディオブックのように、読む内容が決まっている用途向けです。
- Live API(Gemini 3.8 Live など)
-
テキスト、画像、音声、動画の入力に対して、低遅延でテキストや音声を返します。リアルタイムの音声対話向けです。
- Transcribe(Gemini 3.5 Transcribe など)
-
音声をテキストに書き起こします。TTS とは入出力が逆の関係です。
- テキストモデル(Gemini 3.8 Flash など)
-
文章の生成や要約を行います。音声生成には対応していないため、原稿の作成と読み上げを分ける場合はテキストモデルと TTS を組み合わせます。
Gemini API のガイドも、Live API を動的な対話向け、TTS を決められた原稿を正確に読み上げる用途向けと位置づけています。音声エージェントのように TTS を組み込む構成でも、応答文は別のモデルで生成し、ターンごとに TTS を呼び出す形が案内されています。
参考: Text-to-speech generation (TTS)(Gemini API 公式ドキュメント)
“tailored for scenarios that require exact text recitation”
(原稿どおりの正確な読み上げが求められる場面向けに設計されている)
https://ai.google.dev/gemini-api/docs/speech-generation
Flash TTS と Flash-Lite TTS の比較
2 モデルの主な違いは、公式の推奨用途、料金、対応言語数です。対応機能、API の形式、トークン上限は共通しています。
| 項目 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| モデル ID | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| 公式の推奨用途 | 表現力の高い演技、難しい発音、地域の方言、複雑な複数話者の対話、長尺のナレーション | 大量生成、音声エージェント、読み上げ機能、日常的な単一話者の音声、声の複製 |
| 対応言語 | 130 言語(日本語を含む) | 101 言語(日本語を含む) |
| 単一話者/複数話者 | 対応/対応 | 対応/対応 |
| 声の設計/声の複製 | 対応/対応 | 対応/対応 |
| 入力/出力トークン上限 | 8,192/16,384 | 8,192/16,384 |
| 音声出力の単価(Standard、2026 年末まで) | 100 万トークンあたり $9.00 | 100 万トークンあたり $6.00 |
| 公式の位置づけ | 新しい上位の表現重視モデル | gemini-3.1-flash-tts-preview の置き換え |
Flash TTS のモデルページには、国際音声記号(IPA)による発音の上書きへの対応も記載されています。記法と日本語での挙動は本記事では確認していないため、製品名の読みを細かく制御したい場合は公式ドキュメントで確認してください。
声の設計と複製は Flash 専用ではない
公式発表では、Flash TTS の説明の中で声の設計(Voice design)と声の複製(Voice replication)が紹介されています。一方、Gemini API ガイドの対応モデル表と Voice replication のドキュメントでは、Flash-Lite TTS も声の設計と声の複製に対応しています。発表記事の構成だけで Flash 専用と判断しないよう注意してください。
音声ライブラリの規模も、情報源によって表現が異なります。公式発表は 2,000 以上の音声を利用できるとし、API ガイドは 30 種類のプリビルト音声と、数百の音声を含む Extended Voice Library と説明しています。利用できる音声は、voices.list() で言語や用途を指定して確認できます。
声の複製を使わなくても研修ナレーションの評価は始められるため、ここでは要件の確認にとどめます。複製には、同じ成人話者による 10〜30 秒の参照音声と、所定の同意文を読み上げた同意音声の 2 つが必要で、同意文には日本語版も用意されています。公式発表は 30 秒の音声サンプルと表現していますが、ドキュメント上の要件は 10〜30 秒です。また公式発表の注記によると、Google AI Studio での声の複製は、米国のイリノイ州とテキサス州、EEA、英国、スイス、インドでは利用できません。社員の声を使う場合は、本人の同意に加えて、利用範囲や異動・退職後の扱いを社内で取り決めておくことをおすすめします。
なお、ライブラリの音声の声質や話速を調整する Voice remixing は、公式発表で「近日提供」とされている機能です。本記事では現行の機能に含めていません。
日本語の説明音声で試すモデルの選び方
公式の推奨用途を業務用ナレーションに当てはめると、最初に試すモデルは次のように整理できます。これは編集上の選定案であり、日本語での品質差を検証した結果ではありません。
| 想定する用途 | 最初に試すモデル | 根拠とした公式の推奨用途 |
|---|---|---|
| 社内研修・操作説明の単一話者ナレーション(本数が多い、定期的に更新する) | Flash-Lite TTS | 大量生成、読み上げ機能、日常的な単一話者の音声 |
| 製品名、略語、固有名詞が多い原稿 | 2 モデルを比較 | Flash TTS は難しい発音を推奨用途に含む |
| 2 人の掛け合い形式の解説 | Flash TTS | 複雑な複数話者の対話 |
| 長尺のナレーション | Flash TTS | 長尺のナレーションでの声と音響の安定性 |
どの用途に当てはまる場合でも、最終的には同じ原稿で 2 モデルを生成して比べる方法をおすすめします。API の形式が共通なので、比較のための実装変更はモデル名の変更だけで済みます。
利用できるサービスと料金
提供状況は利用経路ごとに異なり、料金も通常の Gemini モデルとは別体系です。
提供経路と提供時期
公式発表のリード文には 5 つのサービス名が並んでいますが、提供状況は同じではありません。発表末尾の案内をモデル別に整理すると次のとおりです。「順次展開」は発表当日から展開が始まったことを示すもので、すべてのアカウントで同日に利用できることを意味しません。
| 提供経路 | Flash TTS | Flash-Lite TTS | 対象 |
|---|---|---|---|
| Gemini API | 発表日から順次展開 | 発表日から順次展開 | 開発者 |
| Google AI Studio | 発表日から順次展開 | 発表日から順次展開 | 開発者(声の複製は一部地域で利用不可) |
| Gemini Enterprise(API) | 今後提供予定 | 今後提供予定 | 企業 |
| Gemini Notebook | 発表日から順次展開 | 記載なし | 一般向け製品への組み込み |
| Google Vids | 記載なし | 発表日から順次展開 | 一般向け製品への組み込み |
参考: Google「Gemini 3.8 text-to-speech says hello」
“Coming soon via API in Gemini Enterprise”
(Gemini Enterprise では API 経由で近日提供予定)
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-text-to-speech/
Gemini Notebook と Google Vids は一般向け製品への組み込みであり、Gemini API の料金表や追加利用規約がそのまま適用されるものではありません。発表では、各製品で使える機能の範囲や日本での提供時期までは示されていないため、製品側の案内で確認してください。
Gemini 3.8 TTS の料金(Standard)
料金は 100 万トークンあたりの米ドルで、入力はテキスト、出力は音声として課金されます。単価は 2026 年 12 月 31 日までと 2027 年 1 月 1 日以降で分かれており、2027 年からは入力・出力とも 2 倍の単価になります。
| 適用期間 | Flash TTS 入力 | Flash TTS 出力 | Flash-Lite TTS 入力 | Flash-Lite TTS 出力 |
|---|---|---|---|---|
| 2026 年 12 月 31 日まで | $0.50 | $9.00(音声 10 秒あたり $0.00225) | $0.50 | $6.00(音声 10 秒あたり $0.0015) |
| 2027 年 1 月 1 日から | $1.00 | $18.00(音声 10 秒あたり $0.0045) | $1.00 | $12.00(音声 10 秒あたり $0.003) |
参考: Gemini Developer API pricing(Gemini API 公式ドキュメント)
“Audio tokens correspond to 25 tokens per second of audio.”
(音声トークンは、音声 1 秒あたり 25 トークンに相当する)
https://ai.google.dev/gemini-api/docs/pricing
Batch と Flex は Standard の半額で、即時性が不要な大量生成では選択肢になります。無料枠は Standard と Priority で提供され、入力・出力とも無料です。置き換え対象とされる Gemini 3.1 Flash TTS Preview の Standard 単価は、100 万トークンあたり入力 $1.00、出力 $20.00 です。2027 年以降の Flash-Lite TTS と比べると、入力は同じ $1.00、出力は $20.00 に対して $12.00 です。
通常の Gemini 3.8 Flash の単価(2026 年末まで入力 $0.75、出力 $3.75)は、TTS モデルとは別の料金です。テキストモデル側の料金と移行の考え方は『Gemini 3.8 Flash の料金と使い分け|Cyber は限定提供』で整理しています。
10 分の説明音声を作る場合の試算
音声の出力トークンは 1 秒あたり 25 トークンなので、10 分(600 秒)の音声は 15,000 トークンになります。Standard の有料ティアで 1 回生成した場合の概算は次のとおりです。
| 項目 | Flash TTS | Flash-Lite TTS |
|---|---|---|
| 音声出力トークン(600 秒 × 25) | 15,000 | 15,000 |
| 音声出力の料金(2026 年末まで) | $0.135 | $0.09 |
| 音声出力の料金(2027 年から) | $0.27 | $0.18 |
| 入力の料金(仮定 5,000 トークン、2026 年末まで) | $0.0025 | $0.0025 |
| 入力を含む合計(2026 年末まで) | 約 $0.14 | 約 $0.09 |
入力トークン数は原稿の文字数や style の指定で変わるため、ここでは編集上の仮定として 5,000 トークンとしています。実際の値はトークン数の計算機能で確認してください。この仮定では、費用の大半は音声の出力料金です。
この試算は 1 回の生成分であり、再生成、確認作業の人件費、音声の編集や配信の費用は含みません。読み間違いの修正で全体を 3 回生成し直せば、生成費用も 3 倍になります。修正箇所だけを再生成できるよう、原稿をセクション単位に分けておくと費用の増加を抑えやすくなります。1 回のリクエストで生成できる長さの目安は、後述の「複数話者と長時間音声の制約」で説明します。
無料枠と有料利用でのデータの扱い
無料で試せることと、業務データを入力してよいかは別の問題です。Gemini API の追加利用規約は、無料で提供されるサービス(Unpaid Services)と有料サービス(Paid Services)で製品改善へのデータ利用を分けています。この区分は実際の支払いの有無ではなく、規約上の条件で決まります。
| 規約上の区分 | 該当する条件 | 製品改善への利用 | 人によるレビュー |
|---|---|---|---|
| 無料サービス(Unpaid Services) | 有料サービスの条件に当たらない Google AI Studio の利用、有効な請求先アカウントに紐づかない Gemini API の利用(無料枠を含む) | 利用される | 品質向上のため、アカウントなどと切り離したうえで入出力が読まれる場合がある |
| 有料サービス(Paid Services) | 有効な請求先アカウントに紐づく Cloud プロジェクト経由の Gemini API の利用 | 利用されない | 製品改善を目的とするレビューの記載なし |
| 有料サービス(Paid Services) | 有効な請求先アカウント付き Cloud プロジェクトにアクセスできるアカウント、または Workspace の企業向けアカウントでの Google AI Studio の利用(料金が発生していなくても該当) | 利用されない | 製品改善を目的とするレビューの記載なし |
注記: EEA、スイス、英国では、Google AI Studio と Gemini API の無料枠を含むすべての利用に、有料サービスのデータ利用条件が適用されます。
参考: Gemini API Additional Terms of Service
“Do not submit sensitive, confidential, or personal information to the Unpaid Services.”
(機微な情報、機密情報、個人情報を無料サービスに送信しないこと)
https://ai.google.dev/gemini-api/terms
製品改善への利用とは別に、次のデータ保存があります。「製品改善に使われない」ことは「保存されない」ことを意味しません。
| 保存の種類 | 適用範囲 | 対象と期間 |
|---|---|---|
| 不正利用監視のためのログ | Gemini API と Google AI Studio の利用(有料・無料を問わない) | プロンプト、付随する文脈情報、出力を 55 日間保持。違反の疑いで検知された内容は、権限のある従業員が確認する場合がある |
| 保存したカスタム音声 | 設計・複製した音声を store=True で作成した場合 | プロジェクト内に保存され、有効期間は 1 年(store=False のキーは 7 日) |
参考: Abuse monitoring(Gemini API 公式ドキュメント)
“Google retains the following data for fifty-five (55) days”
(Google は次のデータを 55 日間保持する)
https://ai.google.dev/gemini-api/docs/usage-policies
Abuse monitoring のページは、このログを利用規約違反の検知と防止、法令上必要な開示の目的に限って使い、ポリシー執行用以外のモデルの学習には使わないとしています。また追加利用規約では、有料サービスのデータは Google の拠点がある国で一時的に保存またはキャッシュされる場合があるとされています。社内規程で保存期間や保存場所に条件がある場合は、これらを含めて確認することをおすすめします。
日本語音声を試す流れと既存実装の注意点
評価は Google AI Studio で短い原稿から始め、API の実装は評価結果を見てから進めると手戻りを減らせます。既存の TTS 実装がある場合は、入力形式と出力形式の変更点を先に確認してください。
Google AI Studio で日本語音声を試す手順
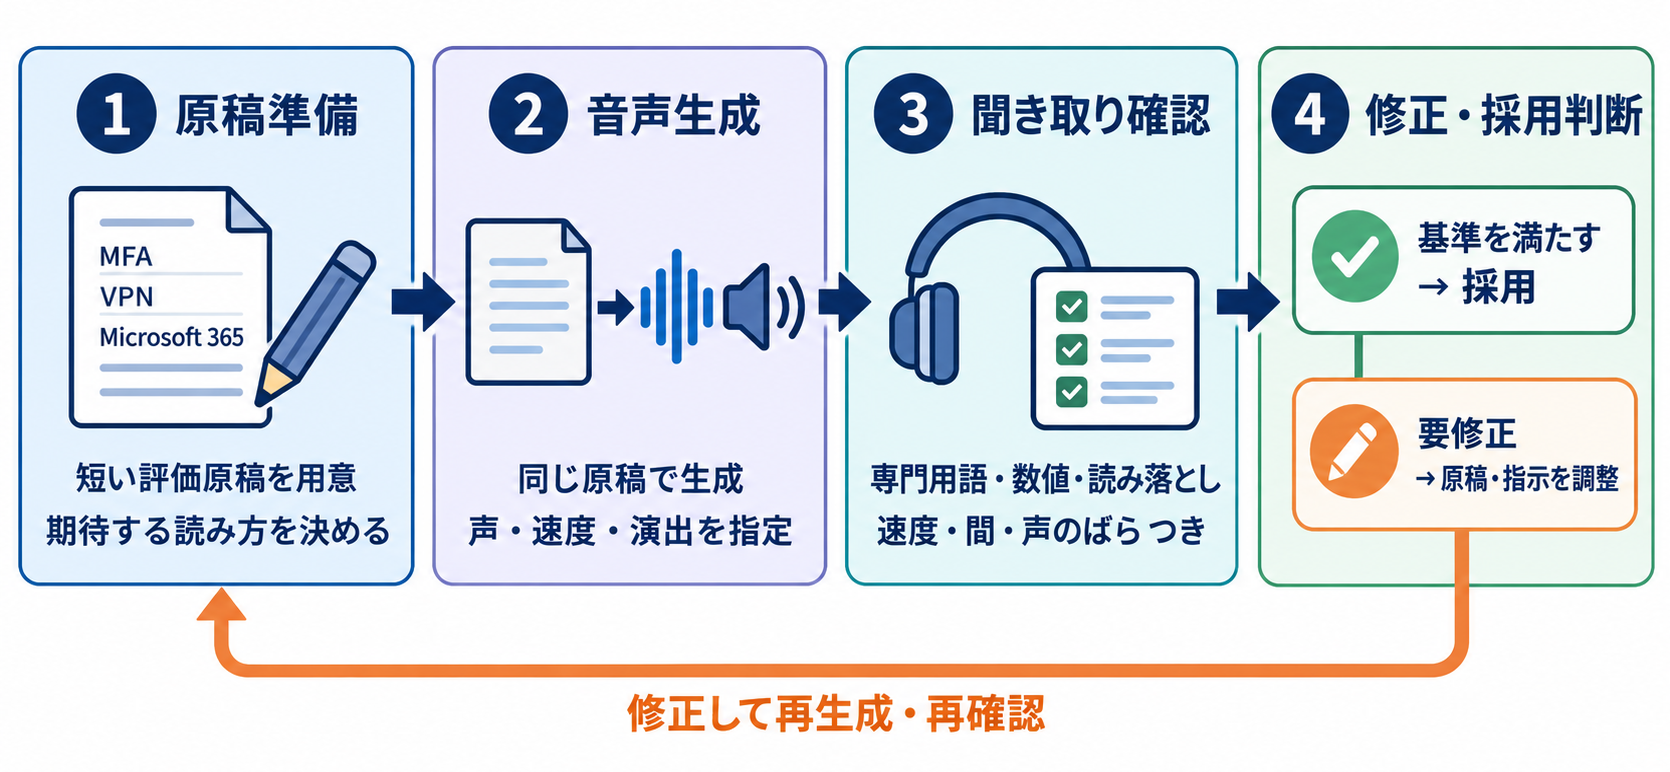
実在の社内情報を含まない、1 分程度の原稿を用意します。後述の評価用原稿を流用できます。
Google AI Studio の音声生成画面で gemini-3.8-flash-lite-tts を選び、音声を 1 つ決めて生成します。ガイドは、まず style を空にして生成し、必要な箇所にだけ短い指示を加える進め方を推奨しています。
原稿と音声を変えずに、モデルだけを gemini-3.8-flash-tts に切り替えて生成します。条件をそろえることで、モデルの違いだけを比較できます。
期待する読みの表と照らし合わせ、読み間違い、読み飛ばし、言い換えがないかを確認します。同じ原稿で 2〜3 回生成し、読み方や声質のばらつきも確認します。
読み誤りは原稿の表記を変えて再生成し、速度や間は style や <short pause> で調整します。品質、費用、データの扱いの条件がそろった時点で、API 実装へ進むかを判断します。
評価の段階では、架空の原稿を使うことをおすすめします。規約上の区分の確認が終わる前でも、データの扱いを気にせずに評価を始められます。
旧 TTS モデルから移行する際の変更点
gemini-3.1-flash-tts-preview 以前の Gemini TTS を使っている場合、モデル名を変えるだけでは移行できません。Gemini 3.8 TTS は入力テキストを逐語的な読み上げ原稿として扱うため、本文に埋め込んでいた演出指示や話者ラベルが読み上げられる可能性があります。
参考: Gemini 3.8 Flash TTS(Gemini API 公式ドキュメント)
“Inline text directions like “Say cheerfully: Hello!” or “Speaker 1: Hello!” may be spoken aloud.”
(「Say cheerfully: Hello!」や「Speaker 1: Hello!」のような本文中の指示は、そのまま読み上げられる可能性がある)
https://ai.google.dev/gemini-api/docs/models/gemini-3.8-flash-tts
公式の Migration guide に沿って、主な変更点を整理すると次のとおりです。
| 項目 | 旧モデル(3.1 Flash TTS Preview 以前) | Gemini 3.8 TTS |
|---|---|---|
| 話し方の指示 | 本文に埋め込む(例: Say cheerfully:) | speech_metadata の style に移す |
| 話者の指定 | 本文内のラベル(例: Speaker 1:) | 各ターンの speech_metadata の speaker で指定する。複数話者では全ターンで指定が必要 |
| 瞬間的な発声や間 | 本文中の指示で表現 | 本文内の山括弧タグ(<short pause>、<sigh> など)。日本語の原稿でもタグは英語で記述 |
| 長い演出ブロック | Audio Profile や Director’s Notes を本文に記述 | Voice design で音声を作成し、その音声 ID を指定する |
| 非ストリーミングの出力形式 | ヘッダーなしの PCM(audio/l16) | RIFF ヘッダー付きの WAV(audio/wav)。自前で WAV ヘッダーを付ける処理は外す |
| ストリーミングの出力形式 | 移行ガイドに記載なし | ヘッダーなしの PCM(audio/l16) |
Interactions API では各テキストブロックの annotations に、GenerateContent API では各 part に speech_metadata を付けます。電話系のシステムへ渡す場合など、ヘッダーなしの PCM、μ-law、A-law が必要なときは、response_format の mime_type で明示的に指定します。
公式ガイドの言語別サンプルにも注意が必要です。2026 年 9 月 25 日に確認した時点で、Go のサンプルの一部には旧モデル名の gemini-3.1-flash-tts-preview と、本文に話し方の指示を埋め込む形式、WAV ヘッダーを自前で付ける処理が残っていました。サンプルを流用する場合は Python や REST のサンプルと突き合わせ、モデル名と入力形式を確認してください。
日本語の単一話者音声を保存する最小例
公式ガイドの Python サンプルをもとに、日本語の原稿を単一話者で生成し、WAV として保存する例です。当ブログでは実行していない未検証の例であり、SDK のバージョンと最新のガイドを確認したうえで利用してください。
import base64
from google import genai

MODEL = "gemini-3.8-flash-lite-tts"  # 比較時は "gemini-3.8-flash-tts" に変更

client = genai.Client()

interaction = client.interactions.create(
    model=MODEL,
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "本日は、MFA の設定手順を説明します。",
            "annotations": [{
                "type": "speech_metadata",
                "style": "calm and clear",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": "Kore"},
        ]
    },
)

with open("sample_ja.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
非ストリーミングの応答は RIFF ヘッダー付きの WAV で返るため、受け取ったデータをそのまま .wav として保存できます。style の指定例はガイドに合わせて英語にしています。Kore はガイドのサンプルで使われているプリビルト音声で、日本語の説明音声に合う音声は voices.list() で言語を指定して探せます(google-genai 2.25.0 以降)。
複数話者と長時間音声の制約
1 回のリクエストで生成できる複数話者の音声は、プリビルト音声を使った 2 人までです。設計・複製した音声で掛け合いを作る場合は、話者ごとにターンを個別に生成し、24 kHz の PCM 音声を連結する方法がガイドで案内されています。
また、公式発表の「数時間の連続音声でも声質や話し方を保てる」という説明は、1 回のリクエストで数時間分を出力できるという意味ではありません。モデルページの出力トークン上限は 16,384 で、1 秒 25 トークンで換算すると約 655 秒(約 10 分 55 秒)が計算上の上限です。この換算は編集上の計算であり、公式に示された最大秒数ではありません。10 分程度の音声は上限に近いため、研修音声はセクション単位で分割して生成することをおすすめします。
業務利用前の確認項目
日本語に対応していることと、業務の説明音声として誤りなく読めることは、分けて確認する必要があります。公式発表では、Voice Arena のブラインド評価で日本語を含む主要言語において上位を占めたとされていますが、これは Google が示した評価結果です。社内の専門用語や操作手順の読み上げ精度を保証するものではありません。
日本語の業務用ナレーションを採用する前の確認表
次の表は、当ブログが編集上の評価案として作成したものです。実機での検証結果ではありません。
| 確認項目 | 確認方法 | 問題があった場合の対処例 |
|---|---|---|
| 製品名、略語、英数字の読み | 期待する読みの一覧と照合する | 原稿の表記をカタカナに置き換える。Flash TTS でも比較する |
| 日付、時刻、数値、単位の読み | 期待する読みの一覧と照合する | 読み誤りやすい箇所を、読みに近い表記へ書き換える |
| 否定表現と操作順序 | 生成音声を書き起こし、原稿と突き合わせる | 1 文を短くし、否定や順序を示す語を明確にする |
| 説明音声としての速度と間 | 実際の画面操作やスライドに合わせて再生する | style で速度を指定し、<short pause> で間を入れる |
| 再生成時の声質と読み方のばらつき | 同じ原稿と音声で 2〜3 回生成して聞き比べる | 音声と短い style を固定し、長い演出指示を避ける |
| 修正・再生成を含む費用と確認工数 | 生成回数、生成秒数、確認時間を記録する | セクション単位で生成し、修正箇所だけを再生成する |
| 利用条件 | 規約上の区分、データの保持、SynthID の扱いを確認する | 規約上の有料サービスに該当する環境で運用し、社内規程と照合する |
否定表現と操作順序の確認では、生成音声を文字起こしモデルで書き起こし、原稿と機械的に比較する方法も考えられます。文字起こし側の仕様は『Gemini 3.5 Transcribe とは|文字起こしの機能・料金・制限』で整理しています。ただし書き起こしの誤りも混ざるため、最終確認は人が聞いて行うことをおすすめします。
SynthID は、公式発表によると Gemini Audio モデルで生成したすべての音声に埋め込まれる、聞き取れない電子透かしです。生成音声を社外にも配布する場合は、AI 生成物の表示に関する社内方針とあわせて確認してください。
評価用の短い日本語原稿の例
次の原稿は、確認表の項目を 1 分程度で確認するための架空の例です。実在の社内情報は含んでいません。
社内システム操作研修、第 3 回です。本日は、MFA と VPN の設定を確認します。2026 年 10 月 1 日から、Microsoft 365 へのサインインには MFA を使います。手順は 3 つです。まず、認証アプリを開きます。次に、表示された 6 桁のコードを入力します。最後に、VPN クライアントを起動します。なお、このコードをほかの人に伝えてはいけません。生成した音声は、次の表と照合します。
| 原稿の箇所 | 期待する読み | 確認の観点 |
|---|---|---|
| 第 3 回 | だいさんかい | 数字と助数詞 |
| MFA | エムエフエー | 略語をアルファベットで読むか |
| VPN | ブイピーエヌ | 略語をアルファベットで読むか |
| 2026 年 10 月 1 日 | にせんにじゅうろくねん じゅうがつ ついたち | 日付の特殊な読み |
| Microsoft 365 | 社内で定めた読み(例: マイクロソフト サンロクゴ) | 製品名に含まれる数字の読み |
| 6 桁 | ろっけた | 数字と助数詞の音の変化 |
| まず/次に/最後に | 3 語とも読まれる | 操作順序の読み落とし |
| 伝えてはいけません | 否定形のまま読まれる | 否定表現の読み落としや言い換え |
期待する読みは組織によって異なる場合があります。特に製品名は、社内の研修資料やマニュアルで使っている読みに合わせて表を作成してください。
まとめ
Gemini 3.8 TTS は、テキストを逐語的に読み上げる音声生成専用のモデルで、Flash TTS と Flash-Lite TTS は API の形式と主な機能が共通です。日本語の業務用ナレーションでは、公式の推奨用途をもとに試すモデルを決め、同じ短い原稿で読み方、費用、データの扱いを確認してから採用を判断することをおすすめします。
- 日本語、声の設計、声の複製は 2 モデルとも対応
- Flash-Lite は大量の単一話者音声、Flash は表現力と難しい発音向け
- Gemini Enterprise での API 提供は今後の予定
- TTS の単価は 2027 年 1 月 1 日から入力・出力とも 2 倍
- 10 分の音声出力は 2026 年末まで Flash-Lite TTS で約 $0.09
- 規約上の無料サービスでは入力が製品改善に使われるため業務データは避ける。
- 旧モデルからの移行時は speech_metadata と WAV 出力への対応を確認する。
以上、最後までお読みいただきありがとうございました。