はじめに
2026 年 9 月 22 日、Anthropic は Claude 5.5 ファミリーの最初のモデルとして Claude Opus 5.5 を公開しました。7 月の Claude Opus 5 から約 2 か月での更新で、API 単価の引き下げに加え、effort の既定値や API の仕様にも変更があります。
業務で使う立場では、「性能がどれだけ上がったか」だけでなく、「料金や設定の変更によって、これまでの使い方を見直す必要があるか」が判断の中心になります。この記事では、Anthropic の公式発表と Claude Platform のドキュメント、Claude ヘルプセンターを一次情報として、Opus 5 からの変更点と使い始めの確認事項を整理します。Opus 5 自体の性能や制限は、既存記事『Claude Opus 5 の性能と制限|Fable 5 半額の実力とサイバー用途の境界』で扱っています。
- Claude Opus 5.5 と Opus 5 の違い(公式評価と仕様上の事実の区別)
- API 料金の変更点と「実行コスト 40% 削減」の読み方
- 利用できる環境とサブスクリプションの変更点
- effort の既定値が medium(中)になった意味と設定の考え方
- 既存の API 連携で確認したい変更点とセーフガードの扱い
結論を先に述べます。Claude Opus 5.5 は、1M トークンのコンテキストウィンドウと 128K トークンの最大出力を据え置いたまま、API の入出力単価を入力 $4・出力 $20(100 万トークン当たり)へ 20% 引き下げた Opus 5 の後継モデルです。性能面では、文章が要点から書かれて読みやすくなったこと、資料分析で誤った数値や出典の取り違えが減ったこと、図表や画面の読み取りが正確になったことを、Anthropic が主な改善点として挙げています。effort は既定の medium で試し始め、重要事項の見落としや複雑な条件処理の不足が見えた作業だけ high と比較する進め方が現実的です。既存の API 連携では、thinking の無効化や強制ツール呼び出しなど、Opus 5 では通っていたリクエストが 400 エラーになる変更があるため、切り替え前の確認をおすすめします。
Claude Opus 5.5 の概要と Opus 5 との違い
Opus 5.5 は、長時間のエージェント型コーディングと知識労働を主な用途とするモデルです。公式発表では、多くの作業で Claude Fable 5.1 と同等の水準にありながら、Opus 5 より低いコストで動作すると説明されています。
仕事の例で見る主な改善点
公式発表と Claude Platform のドキュメントが挙げる改善点を、業務の例に置き換えて整理します。いずれも Anthropic と早期テスター(公開前の評価に参加した企業)による評価であり、利用者の環境で同じ効果が得られることを保証するものではありません。
- コーディングと長時間の作業
-
大規模なコードベースの移行や監査など、長く続く作業を得意とすると説明されています。Anthropic のテストでは、既定の medium で Opus 5 の high と同等以上の結果を、より少ないステップとトークンで得たとされています。コードレビューでも、Opus 5 より多くのバグを検出し、誤検出が少なかったと早期テスターが報告しています。
- 資料の分析
-
誤った数値の記載や出典の取り違えが大幅に減ったとされています。財務モデルの作成、評価用ワークブックの誤りの修正に加え、長いやり取りの中の日付と曜日の食い違いや、スライドのグラフと元データの不一致など、大量の入力に埋もれた細部に気付きやすくなったと説明されています。
- 文章・説明
-
重要な情報を冒頭に置き、専門用語や独特の言い回しを避け、指定した文章ルールに従いやすくなったとされています。Opus 5 に対して多く寄せられた「読みにくさ」への指摘に対応した変更です。
- 図表・画面の読み取り
-
密度の高いグラフ、構成図の矢印がどの箱をつないでいるか、カレンダーのスクリーンショット上の時刻など、位置関係に依存する情報の読み取りが改善したとされています。画面を見て PC を操作するコンピューター操作でも、既定の effort で、Opus 5 がより高い effort で達成した成功率に並んだと説明されています。
代表的なベンチマークと読み方
公式発表には多数のベンチマークが掲載されています。ここでは、実務との関係が分かりやすい 4 つに絞ります。
| 指標 | 測っている内容 | Opus 5.5 | Opus 5 |
|---|---|---|---|
| Terminal-Bench 4.0 | コマンドライン上での複数段階の専門的な作業の完遂 | 66.4% | 52.3% |
| GDPval-AA v2.1 | 44 職種の実務を想定した成果物の評価(Elo) | 1846 | 1708 |
| OSWorld 2.0 | 画面を見て PC を操作する作業の完遂(部分点あり) | 81.8% | 74.0% |
| Chartography | グラフ・図表からの値の読み取り(ツール使用) | 89.0% | 83.4% |
この一覧は、既定の medium で測った結果ではありません。脚注によると、Opus 5.5 の結果は原則として max、Terminal-Bench 4.0 のみ xhigh で測定されています。また、本番と同じセーフガードを有効にした状態で測定され、介入が発生した場合はサイバーセキュリティのタスクを Claude Opus 4.8、生物学とフロンティア LLM 開発のタスクを Opus 5 が処理したと記載されています。
既定の medium での結果は、コーディング系の一部の指標で本文に別途示されています。Anthropic 自身も、この性能水準ではベンチマークの差が実務上の差を示す指標として信頼しにくくなっていると述べています。自社での期待値は、公表値ではなく自分の作業で測り直すことをおすすめします。
Opus 5 との比較表
仕様上の事実と Anthropic の評価を分けて整理します。「区分」が「仕様」の行は公式ドキュメントに記載された値、「公式評価」の行は Anthropic による測定・説明です。
| 項目 | 区分 | Opus 5 | Opus 5.5 |
|---|---|---|---|
| API モデル ID | 仕様 | claude-opus-5 | claude-opus-5-5 |
| 入力・出力の単価(100 万トークン当たり) | 仕様 | $5・$25 | $4・$20 |
| キャッシュ読み取り | 仕様 | $0.50 | $0.20 |
| キャッシュ書き込み(5 分) | 仕様 | $6.25 | $5 |
| コンテキストウィンドウ・最大出力 | 仕様 | 1M・128K トークン | 1M・128K トークン(据え置き) |
| 知識のカットオフ | 仕様 | 2026 年 5 月 | 2026 年 6 月 |
| thinking | 仕様 | adaptive(high 以下で無効化可) | adaptive(常時オン、無効化不可) |
| API の effort 既定値 | 仕様 | high | medium |
| 強制ツール呼び出し | 仕様 | 対応 | 非対応(400 エラー) |
| Claude アプリでの別モデルへの切り替え | 仕様 | サイバー(Opus 4.8 へ) | サイバー(Opus 4.8 へ)、生物・フロンティア LLM 開発(Opus 5 へ) |
API の拒否カテゴリー(stop_details.category) | 仕様 | cyber | cyberbioreasoning_extraction |
| 典型的な作業の実行コスト | 公式評価 | 基準 | 既定の設定で約 40% 減 |
| 出力トークンの生成速度 | 公式評価 | 基準 | 30% 超の向上 |
| プロンプトインジェクションへの耐性 | 公式評価 | 基準 | 検証したすべての設定で同等以上 |
Opus 5.5 の料金と利用できる環境
API の料金は、単価と作業当たりのコストの両面で下がっています。ただし、公表されている数値はそれぞれ意味が異なるため、区別して読む必要があります。
API 料金と「実行コスト 40% 削減」の読み方
API の入出力単価は、Opus 5 の入力 $5・出力 $25 から、入力 $4・出力 $20 へ変更されました(100 万トークン当たり)。キャッシュ読み取りは $0.50 から $0.20、5 分のキャッシュ書き込みは $6.25 から $5 です。1 時間のキャッシュ書き込みは $8、バッチ処理は半額の入力 $2・出力 $10 と記載されています。
参考: Introducing Claude Opus 5.5(Anthropic 公式発表)
“at default settings it will cost 40% less than Opus 5 on typical workloads”
(既定の設定では、典型的な作業において Opus 5 より 40% 低いコストになる)
https://www.anthropic.com/claude-opus-5-5
この 40% について、次の 3 点を区別しておくと誤解を避けられます。
- 入出力単価の引き下げ幅は 20% です。40% は、単価の低下に加えて 1 タスク当たりのトークン数が減る効果を合わせた、Anthropic のテストによる典型的な作業での評価です。
- 40% は「既定の設定」での評価です。Opus 5 で使っていた high や xhigh をそのまま引き継いだ場合に、同じ削減幅になるとは限りません(同じ effort でも 1 ターン当たりの思考が増える傾向を公式が示していることからの、編集上の推論です)。
- 出力トークンの生成速度が 30% 超向上したことは、作業全体の完了時間が一律に 30% 短くなることを意味しません。作業時間には、思考の量やツールの実行、外部データの取得待ちなども含まれるためです。
ここでの 40% は API の従量課金における実行コストの評価で、Pro や Max などの月額プランの料金が 40% 下がったという意味ではありません。
速度を優先する用途向けに、Fast mode(リサーチプレビュー)も用意されています。最大 2.5 倍の速度で、料金は入力 $8・出力 $40 です。公式発表では Claude Code と Claude Platform で利用できるとされ、ドキュメントでは API 経由の提供を Claude API のみとし、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry では利用できないと記載しています。
提供先とサブスクリプションの変更点
公式発表では、Amazon Web Services、Google Cloud、Microsoft Azure を含むすべてのプラットフォームで提供を開始したとしています。API で利用する場合の提供先とモデル ID は次のとおりです。
| 提供先 | モデル ID・備考 |
|---|---|
| Claude API | claude-opus-5-5(すべての顧客) |
| Amazon Bedrock | anthropic.claude-opus-5-5 |
| Claude Platform on AWS | claude-opus-5-5 |
| Google Cloud | claude-opus-5-5 |
| Microsoft Foundry | claude-opus-5-5 |
Claude Code では、/model コマンドや --model claude-opus-5-5 の指定で Opus 5.5 を選択できると案内されています。モデルの提供終了は 2027 年 9 月 22 日より前には行われない予定で、Zero Data Retention(ZDR)でも利用できます。
Claude のアプリで使う場合、公式製品ページの「Availability and pricing」では、Opus 5.5 を Pro、Max、Team、Enterprise の各プランで利用できると記載しています。確認時点では同ページ上部の見出しに旧モデル名が残っていましたが、利用可能なプランの判断には該当段落の記載を使っています。
あわせて、Pro、Max、Team、シート制の Enterprise プランで 5 時間ごとの利用上限を引き上げることが公式発表で案内されています。利用上限の引き上げ幅は、確認時点(2026 年 9 月 23 日)の公式資料では公表されていません。
一方、サブスクリプション利用者に提供されるリセット(limit reset)は、使い方が公式ヘルプで公開されています。Web 版または Claude Desktop の Settings > Usage から実行し、表示内容に応じて 5 時間ごとの上限か週単位の上限が回復します。有効期限がある場合は同じ画面に表示され、使用後は取り消せません。詳細は公式ヘルプ「What is a limit reset?」で確認できます。
effort が medium(中)になった意味と設定の考え方
effort は、応答にどれだけトークンを使うかを調整する設定です。Opus 5.5 では thinking を無効化できないため、思考量、応答時間、コストを調整する主な手段が effort になります。
API の既定値が high から medium へ
Opus 5 の API では、effort を指定しないリクエストは high で動作していました。Opus 5.5 では既定値が medium に変わっています。
参考: What’s new in Claude Opus 5.5(Claude Platform Docs)
“A request that omits effort runs at medium”
(effort を省略したリクエストは medium で実行される)
https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
effort を指定していない既存の API 呼び出しは、モデル ID を変えると、適用される既定の設定名が high から medium に変わります。ただし、次に説明するとおり同じ設定名でもモデル間で思考量は一致しないため、設定名が変わることと、得られる結果の水準が変わることは同じではありません。既定値と同じ値を明示した場合と省略した場合の挙動は同じと説明されているため、意図した設定がある場合は明示しておくと、既定値の違いに左右されにくくなります。effort は output_config で指定します。
client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16000,
    output_config={"effort": "medium"},
    messages=[{"role": "user", "content": "..."}],
)
effort は思考だけでなく、応答テキストやツール呼び出しを含むすべての出力トークンに影響します。また、厳密なトークンの上限ではなく、低い設定でも難しい問題では思考が行われると説明されています。
同じ effort 名でもモデル間で思考量は同じではない
参考: Prompting Claude Opus 5.5(Claude Platform Docs)
“Effort level names don’t correspond to the same amount of thinking across models”
(effort の名称は、モデル間で同じ思考量に対応していない)
https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-opus-5-5
公式ドキュメントでは、Anthropic のテストにおいて Opus 5.5 の medium がコーディングと知識労働の評価で Opus 5 の high と同等以上であり、いくつかのコーディング評価では low でもそれに近い結果を低いコストで得たとしています。一方で、同じ effort では Opus 5.5 のほうが 1 ターン当たりに多く思考する傾向があり、特に xhigh と max で目立つと説明されています。
| effort | 公式の位置付け | Opus 5.5 での扱い |
|---|---|---|
low | 最も効率的。単純な作業やサブエージェント向け | Opus 5 で thinking を無効化していた処理の置き換えで、最初に試す設定 |
medium | 速度・コスト・性能の均衡 | 既定値。まず試す基準 |
high | 必要なだけトークンを使う | Opus 5 の既定値。medium で不足が見えた場合の比較対象 |
xhigh | 30 分を超える長時間のエージェント作業向け | 品質の向上を測定できた作業に限定 |
max | トークン消費に制約を設けない | 品質の向上を測定できた作業に限定 |
Opus 5 で xhigh や max を使っていた場合、同じ値を引き継ぐと 1 ターンが長くなり、出力トークンが増えることが想定されています。公式は、自分の評価セットで effort を測り直すこと、thinking を含む出力全体の上限である max_tokens に余裕を持たせることを推奨しています。
API・Claude Code・チャット画面の設定を分けて考える
effort の既定値として公式ドキュメントに明記されているのは API の値です。利用経路ごとに、確認できた範囲を整理します。
- Claude API(各クラウド経由を含む)
-
output_config.effortで指定します。既定値の medium は公式ドキュメントに明記されています。1 つの会話の途中で effort を変える場合は、プロンプトキャッシュを維持できるメッセージ単位の変更(ベータ)も利用できます。 - Claude Code
-
/modelや--modelでモデルを選択します。確認時点の公式ヘルプでは、Opus 5.5 を選択したときの effort の初期値を明記した記載は確認できませんでした。画面上の表示で確認することをおすすめします。 - Claude のチャット画面(Web・デスクトップ・モバイル)
-
Opus 5.5 選択時の effort の初期値を明記した公式資料は、確認時点では見つかりませんでした。Enterprise プランには、管理者が利用できるモデルと effort 設定を制御する機能(ベータ)があるため、組織の設定によって選べる範囲が異なる場合があります。
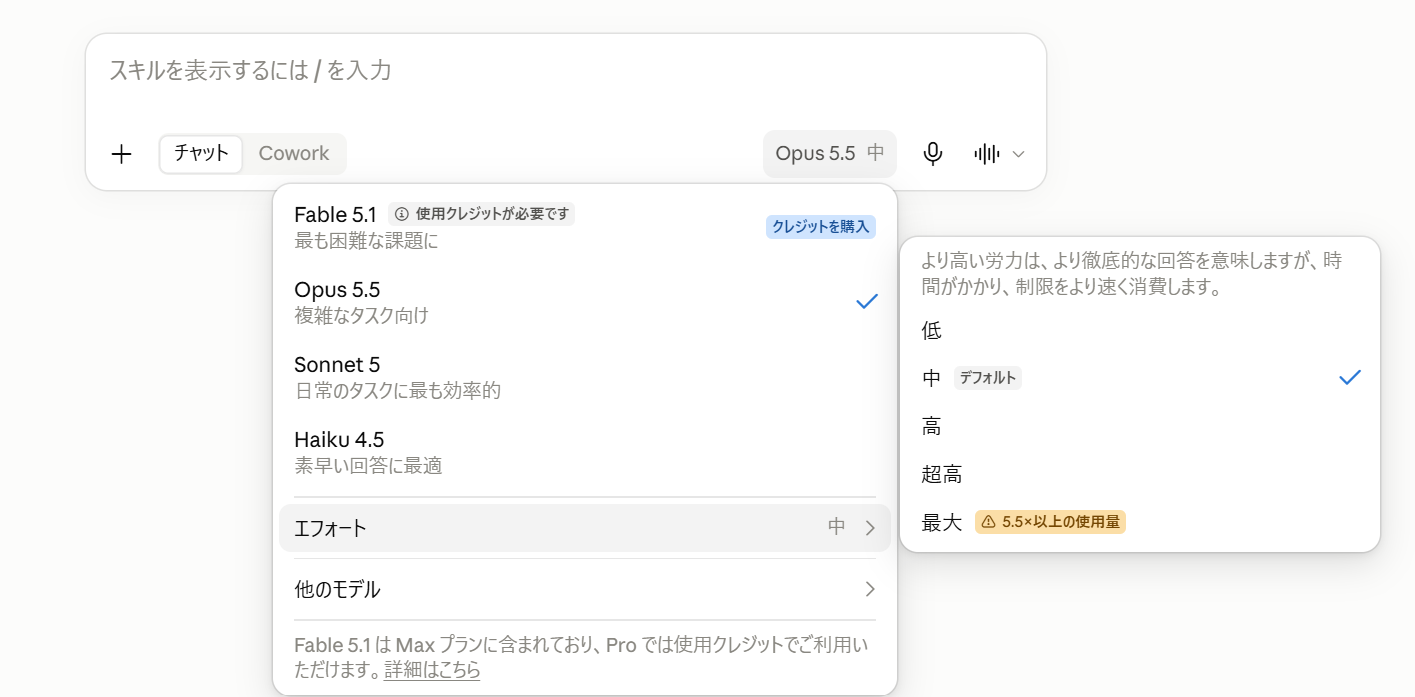
API の既定値が medium だからといって、アプリの初期値も同じとは限りません。社内向けの利用ガイドを作る場合は、経路ごとに画面で確認した値を記載しておくと混乱を防ぎやすくなります。
利用場面別の確認表と API 移行・制限の要点
ここでは、公式資料を踏まえた編集上の提案として利用場面ごとの試し方を整理し、続けて API 移行と利用制限の要点を確認します。利用場面別の整理は、独自に検証した結果ではありません。
利用場面別の確認表
基本の進め方は、medium で試し、結果に重要事項の見落としや複雑な条件処理の不足が見られた作業だけ high と比較する、という順序です。effort を上げても正確さが保証されるわけではなく、入力資料の不足や指示のあいまいさは設定では補えません。
| 利用場面 | 最初に試す設定・確認 | 結果を見て見直す点 |
|---|---|---|
| 文書の要約・説明(議事録、手順書、社内向けの説明文) | medium で試し、要点が冒頭にあるか、固有名詞と数値が原文と一致するかを確認 | 重要事項の抜けや条件分岐の取りこぼしがあれば high と比較。単純な要約で品質が保てるなら low も候補 |
| 資料・データの分析(表計算、ログの集計、報告書) | medium で試し、数値と出典の対応を人が照合 | 誤った数値や根拠の飛躍があれば high と比較。検証手順や確認すべき観点を指示に明記 |
| 図表・画面の読み取り(構成図、ダッシュボード、スクリーンショット) | medium で試し、旧モデル向けに入れていた画像の分割指示などが不要か再確認 | 高密度な図面は高解像度の画像や切り出し用のツールを検討。公式は、ツールなしで effort を上げてもグラフの読み取りはあまり改善しないと説明 |
| コード改修・レビュー | medium で試し、テストの通過と変更範囲を確認 | 広範囲の改修や複雑な条件処理で見落としがあれば high と比較。長時間の自律作業では xhigh も比較対象 |
| 既存の API 連携 | effort を明示し、Opus 5 の値を固定で引き継がず medium と high を並べて評価 | max_tokens、トークン数、応答時間、応答の形式を再計測 |
公式ドキュメントも、xhigh と max は品質の向上を測定できた作業に限定し、思考を減らしたい場合はプロンプトの指示より先に effort を下げることを推奨しています。
既存の API 連携で確認したい変更点
移行ガイドは、Opus 5 で動作しているコードに影響する破壊的変更を 4 つ挙げています。ここでは、該当する実装があるかを判断するための一覧にとどめます。具体的な書き換えは、公式の移行ガイドで確認できます。
| 変更点 | 影響を受ける既存実装 | 対応の方向性 |
|---|---|---|
| thinking を無効化できない | thinking: {"type": "disabled"} や budget_tokens の指定 | 指定を削除し、effort で調整(残すと 400 エラー) |
| 強制ツール呼び出しの非対応 | tool_choice の any・tool(トークン数計測のエンドポイントを含む) | auto と strict tool use、または構造化出力を使い、ツールを使う条件をプロンプトで指示 |
| 思考ブロックがモデルと会話に紐付く | 会話途中でのモデル切り替え、system・tools・過去メッセージの編集 | 会話を追記型で維持。2026 年 8 月 31 日 0 時(UTC)以降に作成したアカウントでは、編集後の再送が既定で 400 エラー |
| 旧 computer use ツールの非対応 | computer_20251124 の利用(Claude API と Google Cloud) | computer_toolset_20260801 へ移行。Amazon Bedrock では引き続き利用可 |
このほか、ツール呼び出しの合間の進捗メモが thinking ブロックで返る変更、会話途中でモデルを切り替えた場合の思考ブロックの引き継ぎ、max_tokens の余裕の取り方、ベータ機能の扱いなど、リクエスト自体は失敗しないものの挙動が変わる点があります。画面に進捗を表示している実装やモデルを振り分けるルーターがある場合は、What’s new in Claude Opus 5.5 と移行ガイドのチェックリストで確認できます。Claude Managed Agents を使っている場合は、モデル名の更新以外の変更は不要とされています。
安全性の評価と利用上の制限
安全性については、「モデルの振る舞いの評価」と「利用できる作業の制限」を分けて読む必要があります。
評価面では、Anthropic の自動行動監査で、不整合な振る舞いのほぼすべての指標において近年の Claude モデルを上回り、プロンプトインジェクションへの耐性も Opus 5 以上とされています。一方で Anthropic は、評価中であることをモデルが推測している兆候があり、実環境での振る舞いを評価しにくくなっていることも記載しています。評価の改善は、権限の分離や承認フローなど運用側の制御を省く根拠にはならないと考えるのが妥当です(編集上の見解)。
利用面では、Opus 5.5 に Fable 5.1 と同等クラスのセーフガードが適用されます。Claude のアプリや Claude Code での扱いは次のとおりです。Opus 5 からの新規追加は生物とフロンティア LLM 開発の切り替えで、サイバーの切り替えと推論抽出の遮断は、ヘルプセンターでは Opus 5 と Opus 5.5 の両方に適用されると説明されています。
| 分野 | 対象となる依頼の例 | Claude アプリ・Claude Code での扱い |
|---|---|---|
| サイバーセキュリティ | エクスプロイトの生成、バイナリベースの脆弱性スキャン、ペネトレーションテスト | Opus 4.8 へ切り替え。ソースコードの脆弱性スキャンやセキュアなコードの作成は利用可 |
| 生物 | ウイルス学、毒性学、分子設計などのデュアルユースの依頼 | Opus 5 へ切り替え。日常的な健康や学習の質問は利用可 |
| フロンティア LLM 開発(Opus 5.5 のみ) | 特定の ML アクセラレーター向けのカーネル開発など | Opus 5 へ切り替え |
| 推論抽出(蒸留対策) | 内部の推論を逐語的に出力させる依頼 | 切り替えずにブロック(Opus 5 と共通) |
Claude のアプリや Claude Code では、自動的なモデル切り替えが既定で有効で、設定(Claude Code では Config > MODEL & OUTPUT)の「Switch models when a message is flagged」でオフにできます。オフにすると、該当する依頼は会話の一時停止として扱われます。判定には最新のメッセージだけでなく、メモリ、コネクター経由の内容、Web 検索の結果、ファイルも含まれます。ソースコードの脆弱性スキャンの進め方は、関連記事『Claude Security プラグインの使い方|脆弱性スキャンとパッチ提案の手順』で扱っています。
参考: Why Claude switched models in your conversation with Opus 5 or Opus 5.5(Claude Help Center)
“API customers must opt into and configure the fallbacks”
(API の利用者は、フォールバックを自ら有効化して設定する必要がある)
https://support.claude.com/en/articles/16049681-why-claude-switched-models-in-your-conversation-with-opus-5-or-opus-5-5
API では自動的な切り替えが既定で無効で、該当する依頼は HTTP 200 と stop_reason の refusal で返ります。API の拒否カテゴリーは、移行ガイドによると Opus 5 の cyber に加えて bio と reasoning_extraction が返るようになります。サーバーサイドフォールバック(fallbacks: "default"、ベータ)を設定すると、カテゴリーごとの推奨モデルで再試行されますが、reasoning_extraction による拒否は再試行されません。「必ず自動で切り替わる」「どの依頼も Opus 5.5 が処理する」とはいえない点に注意が必要です。
防御目的のセキュリティ業務向けの Cyber Verification Program は、確認時点で Opus 5.5 を対象に含んでおらず、今後数週間で拡大する予定とされています。生物分野の研究開発で制限に該当する組織向けには、Life Sciences Verification Program への申請が案内されています。
まとめ
Claude Opus 5.5 は、Opus 5 の主要仕様を据え置いたまま、文章・資料分析・図表の読み取りの改善と、API 単価・作業当たりのコストの引き下げを公式が示した後継モデルです。一方で、effort の既定値や API の仕様が変わっているため、「モデル ID を変えるだけ」で同じ挙動になるとは限りません。medium を基準に自分の作業で試し、既存の連携は破壊的変更の該当有無を先に確認する進め方をおすすめします。
- 文章の読みやすさ、資料分析、図表の読み取りの改善を公式が説明
- API の入出力単価は入力 $4・出力 $20 へ 20% の引き下げ
- 実行コスト 40% 減は既定設定・典型的な作業での公式評価
- API の effort の既定値は high から medium へ変更
- 同じ effort 名でもモデル間で思考量は同じではない。
- thinking の無効化や強制ツール呼び出しは 400 エラーになる。
- API ではセーフガードのフォールバックを自分で設定する必要がある。
以上、最後までお読みいただきありがとうございました。