はじめに
OpenAI は 2026 年 9 月 29 日付で「DevDay 2026 Recap」を公開し、ChatGPT、Codex、モデル、API にまたがる 20 以上の発表をまとめました。その中でも、GPT-6 Astra の生成を高速化する「Ultrafast」は、対象プランと課金の倍率が従来の Fast mode と大きく異なるため、試す前に条件を確認する必要があります。
Ultrafast は新しいモデルではなく、既存モデルをどの速度で処理するかを選ぶサービス階層です。ChatGPT のサブスクリプションで使う場合と API キーで使う場合では、対象条件も課金の仕組みも別になります。さらに、発表の総括と個別の公式資料では、速度の倍率や対象プランの記載に差があります。
この記事では、OpenAI の公式資料をもとに Ultrafast の仕組みと利用条件を整理し、DevDay 2026 のほかの更新から、開発者とインフラ・セキュリティ担当者に関係するものを用途別に紹介します。本記事の速度と料金の値はいずれも公式資料の記載であり、当ブログで実測した値ではありません。
- Ultrafast の位置付けと、Standard / Fast との違い
- ChatGPT Work / Codex と API それぞれの対象条件と課金の仕組み
- API のトークン単価、レート制限、処理リージョンの制約
- 公式資料の間で記載が異なる項目と、その読み方
- DevDay 2026 の注目更新の提供状態と、立場別に確認すべき点
先に結論を示します。Ultrafast は GPT-6 Astra を高速に実行するための上位のサービス階層で、ChatGPT Work / Codex では Pro 500 と条件を満たす Enterprise / Edu、API では全利用者が既定の低いレート制限の範囲で利用できます。Pro 500 では含まれる利用枠を Standard の 8 倍、その後のクレジットを 6 倍の速さで消費し、API の単価も Standard の 6 倍です。「最大 8 倍」はトークン生成速度の値であり、タスク全体の完了時間が 8 分の 1 になることを示すものではありません。
ultrafast とは|高速化される範囲
Ultrafast は、OpenAI が速度を最も重視するワークロード向けの上位の速度階層と位置付けるサービス階層です。モデルの種類ではなく、同じモデルをどの速度で処理するかを選ぶ設定であり、API では service_tier パラメーターで指定します。
対応モデルと提供状態
執筆時点(2026 年 9 月 30 日確認)で、Ultrafast を提供済みのモデルは GPT-6 Astra です。ほかのモデルは、利用環境と資料によって扱いが異なります。
| モデル | ChatGPT Work / Codex | API |
|---|---|---|
| GPT-6 Astra | 提供済み(Pro 500、条件を満たす Enterprise / Edu) | 提供済み(全 API 利用者。既定は低いレート制限) |
| GPT-6.1 Sol | 提供予定。Speed の資料では Standard / Fast のみ対応と記載 | 料金表の Ultrafast 欄に掲載なし |
| GPT-5.6 Sol | 記載なし | Preview。OpenAI のアカウントチームを通じて申請 |
GPT-6.1 Sol の Ultrafast は、総括で「近日提供」とされている段階です。API で Preview として案内されているのは GPT-5.6 Sol であり、GPT-6.1 Sol ではありません。GPT-6.1 Sol の位置付けと API 料金は『GPT-6.1 Sol とは|API 料金の変更点と移行時の注意点』で整理しています。
Standard / Fast / Ultrafast の違い
速度の選択肢は 3 段階です。倍率は、速度、利用枠の消費、API 単価の項目ごとに意味が異なります。
| 項目 | Standard | Fast | Ultrafast |
|---|---|---|---|
| 速度(公式の記載) | 基準 | API ガイドでは最大 2.5 倍。Codex の GPT-5.6 と GPT-5.5 は 1.5 倍 | Codex の GPT-6 Astra でトークン生成が最大 8 倍。API は資料により最大 6 倍または 8 倍 |
| 対応モデル | 各モデル | GPT-6.1 Sol、GPT-6 Astra、GPT-6 Sol、GPT-6 Luna など(提供状況による) | GPT-6 Astra(API では GPT-5.6 Sol が Preview) |
| Codex のプラン利用枠の消費 | 1 倍 | 2.5 倍 | 8 倍 |
| 購入クレジットと Enterprise の従量課金 | 1 倍 | 2 倍 | 6 倍 |
| API 単価(GPT-6 Astra) | 基準 | 2 倍 | 6 倍 |
Codex の資料は、Fast と Ultrafast の課金倍率が速度の向上を表すものではないと明記しています。Ultrafast の速度(最大 8 倍)と利用枠の消費(8 倍)は同じ数字ですが、別の指標です。なお、API の Fast mode は GPT-6 Astra について遅延の SLA を設けていないと案内されています。
参考: Speed(ChatGPT Learn) / Fast mode(OpenAI API ドキュメント) / Ultrafast mode(OpenAI API ドキュメント)
「最大 8 倍」が示す範囲
Codex の資料によると、GPT-6 Astra Ultrafast は Standard の GPT-6 Astra と比べてトークン生成が最大 8 倍速く、総括では毎秒 300 トークンと示されています。ただし、この比較が対象とするのは生成速度です。
参考: Speed(ChatGPT Learn)
“This comparison measures token generation speed, not billing rates or overall task completion time.”
(この比較はトークン生成速度を測ったもので、課金レートやタスク全体の完了時間を示すものではありません)
https://learn.chatgpt.com/docs/agent-configuration/speed
エージェント型の作業では、タスク全体の時間に、モデルがトークンを生成する時間のほか、最初の応答が返るまでの時間、ツール呼び出しの往復、テストやビルドの実行、外部 API の応答待ちが含まれます。Ultrafast が短縮するのは主に生成の部分であり、ツールやテストの実行時間は変わりません。
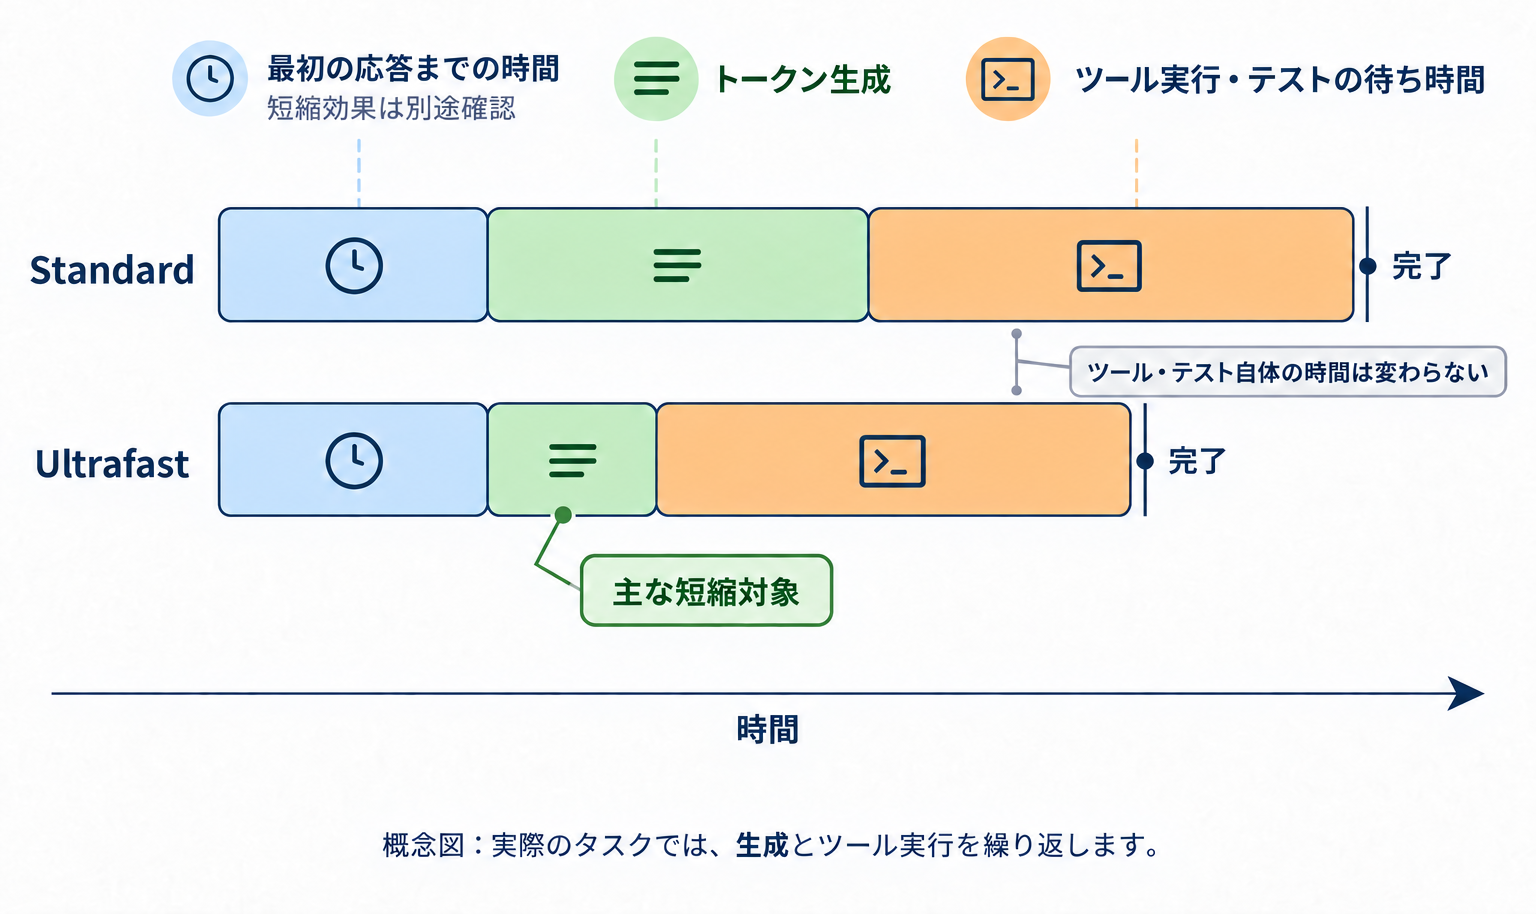
仮に、タスク全体のうち生成時間が 3 割、残りの 7 割がテストや外部ツールの待ち時間だとします。生成が 8 倍速くなっても、全体の所要時間は約 74% にしかならず、短縮幅は約 26% です(0.3 ÷ 8 + 0.7 で計算した編集上の試算)。生成速度が 8 倍になっても、タスク全体が 8 分の 1 の時間で終わるわけではありません。効果が大きいのは、長い出力を対話的に待つ作業のように、生成時間の割合が高い処理です。
ultrafast の料金と利用条件
Ultrafast の条件は、ChatGPT のサブスクリプションで使うか、API キーで使うかで分かれます。まず両者を比較し、その後に個別の条件を補足します。
ChatGPT Work / Codex と API の利用条件比較
| 項目 | ChatGPT Work / Codex | API |
|---|---|---|
| 利用資格 | Pro 500、条件を満たす Enterprise / Edu | 全 API 利用者(既定は低いレート制限) |
| 対応モデル | GPT-6 Astra | GPT-6 Astra(GPT-5.6 Sol は Preview) |
| 課金(Pro 500) | 含まれる利用枠を Standard の 8 倍で消費し、その後は利用可能なクレジットを 6 倍で消費 | トークン単価による従量課金(Standard の 6 倍) |
| 課金(Enterprise / Edu) | 対象となるクレジット制または従量課金契約の条件に従う。購入クレジットと Enterprise の従量課金は Standard の 6 倍で、Enterprise の請求はワークスペースの契約に従う | 上の行と同じ(API の契約で課金) |
| 上限の考え方 | プランの利用枠とクレジット残高。Enterprise では既存のユーザー別支出制御を適用 | 利用ティアごとのトークン毎分(TPM)の上限 |
| 有効化 | Pro 500 はモデル選択画面で選ぶ。Enterprise は既定でオフで、オーナーが許可 | リクエストで service_tier に ultrafast を指定 |
| 処理リージョン | US 以外での推論レジデンシーを求めるワークスペースは対象外 | US データレジデンシーとグローバル処理のみ |
| 相互の関係 | API キーで Codex を使う場合は API のトークン料金が適用され、クレジットの倍率は適用されない | ChatGPT のプランとは別の契約と課金で利用する |
Pro 500 を契約しても API の Ultrafast 料金は別に発生し、逆に API で Ultrafast を使うために Pro 500 の契約は不要です。ChatGPT の利用条件と API の利用資格は、切り離して確認してください。
参考: Speed(ChatGPT Learn) / Ultrafast mode(OpenAI API ドキュメント)
ChatGPT Work / Codex の対象プラン
個人向けの Pro は 3 つの料金プランに分かれ、Ultrafast を含むのは月額 500 米ドルの Pro 500 だけです。ChatGPT Work と Codex は、料金、クレジット、利用上限を共有します。
| プラン | 月額(米ドル) | Ultrafast |
|---|---|---|
| Pro 100 | $100 | 含まれない |
| Pro 200 | $200 | 含まれない |
| Pro 500 | $500 | 含まれる(利用枠は Plus の 25 倍) |
参考: About ChatGPT Pro tiers(OpenAI Help Center)
“At launch, buying credits on Pro 100 or Pro 200 does not unlock Ultrafast.”
(提供開始時点では、Pro 100 または Pro 200 でクレジットを購入しても Ultrafast は利用できません)
https://help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers
Pro 500 では、Ultrafast はプランに含まれる利用枠から先に消費され、枠を使い切った後はクレジット残高から消費されます。Pro 500 の利用枠が Plus の 25 倍である点は、DevDay 2026 Recap の記載です。既存の Pro 200 契約者に 2026 年 10 月 29 日まで旧来の利用枠が据え置かれる措置もありますが、これによって Ultrafast が追加されることはありません。組織向けプランの条件は次のとおりです。
- Enterprise
-
クレジット制または米ドルの従量課金契約のワークスペースが対象です。利用枠ではなくレート制限に基づく旧来の Enterprise 契約は対象外です。既定でオフで、ワークスペースのオーナーが権限設定から、選択したユーザーまたはワークスペース全体に許可します。課金は契約条件に従います。
- Edu
-
クレジットを使うプランが対象です。総括の対象プランには記載がないため、契約形態を確認したうえで利用可否を判断します。
- そのほかのセルフサービスプラン
-
提供開始時点では、クレジットを購入しても利用できません。
日本の組織が確認したいのは、推論のレジデンシー要件です。Codex の資料では、US 以外での推論レジデンシーを求めるワークスペースは Ultrafast の対象外で、ワークスペースの所在地だけでは可否が決まらないと説明されています。国内で推論処理することを要件にしている場合は、その設定が優先されます。
API のトークン単価とレート制限
API の料金表は Standard / Fast / Ultrafast などのタブに分かれています。GPT-6 Astra の単価を、100 万トークンあたりの値で並べると次のとおりです(2026 年 9 月 30 日確認)。
| 処理 | コンテキスト(入力トークン) | 入力 | キャッシュ入力 | キャッシュ書き込み | 出力 |
|---|---|---|---|---|---|
| Standard | 短い(272K 以下) | $10.00 | $1.00 | $12.50 | $50.00 |
| Standard | 長い(272K 超) | $20.00 | $2.00 | $25.00 | $75.00 |
| Fast | 短い(272K 以下) | $20.00 | $2.00 | $25.00 | $100.00 |
| Fast | 長い(272K 超) | $40.00 | $4.00 | $50.00 | $150.00 |
| Ultrafast | 短い(272K 以下) | $60.00 | $6.00 | $75.00 | $300.00 |
| Ultrafast | 長い(272K 超) | $120.00 | $12.00 | $150.00 | $450.00 |
表の「短い」は入力が 272K トークン以下のリクエスト、「長い」は 272K トークンを超えるリクエストです。GPT-6 Astra のモデルページによると、入力が 272K トークンを超えると、入力とキャッシュ(キャッシュ入力・キャッシュ書き込み)の料金が 2 倍、出力の料金が 1.5 倍になります。この割増は 272K トークンを超えた部分だけでなく、リクエスト全体に適用されます。
参考: Pricing(OpenAI API ドキュメント) / GPT-6 Astra Model(OpenAI API ドキュメント)
Ultrafast の単価は、入力、キャッシュ入力、キャッシュ書き込み、出力のすべてで Standard の 6 倍です。Fast は 2 倍で、モデルページにも Fast mode は該当する単価の 2 倍と記載されています。料金表の Ultrafast の表に掲載されているモデルは GPT-6 Astra だけでした。料金表には、2026 年 3 月 5 日以降に公開されたモデルのリージョナル処理(データレジデンシー)エンドポイントに 10% の上乗せがあるとも記載されています。GPT-6 Astra の Standard の料金と提供範囲は『GPT-6 Astra の料金と提供範囲|GPT-5.6 との使い分け』を参照してください。
API の Ultrafast には、Standard とは別に、利用ティアごとの既定のトークン毎分(TPM)上限が設定されています。より高い上限は、OpenAI のアカウントチームと取引のある組織が申請できます。
| API の利用ティア | 既定の TPM 上限(GPT-6 Astra Ultrafast) |
|---|---|
| Tier 1〜3 | 500,000 |
| Tier 4 | 1,000,000 |
| Tier 5 | 5,000,000 |
参考: Ultrafast mode(OpenAI API ドキュメント)
“Ultrafast supports US data residency and global processing only.”
(Ultrafast が対応するのは、US のデータレジデンシーとグローバル処理のみです)
https://developers.openai.com/api/docs/guides/ultrafast-mode
EU など US 以外のリージョナル処理エンドポイントには対応していません。日本から利用する場合も、利用者の所在地ではなく、プロジェクトがグローバル処理を使えるか、US 以外のデータレジデンシーを要件にしていないかで判断します。
API の最小設定例
公式ガイドの HTTP の例では、Responses API のリクエストで model に gpt-6-astra、service_tier に ultrafast を指定します。次は、ガイドに掲載された最小構成の例で、当ブログでは実行していません。
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra",
    "input": "Explain why the sky is blue in one sentence.",
    "service_tier": "ultrafast"
  }'
ツールを短い間隔で何度も呼び出すエージェント型のアプリでは、公式ガイドは WebSocket の利用を強く推奨しています。リクエストごとに接続を張り直すと、その通信のオーバーヘッドによって Ultrafast の短縮効果が目減りするためです。WebSocket モードでは、1 つの接続上で response.create イベントを送り、前の応答の ID を previous_response_id で引き継いで、次のターンやツールの結果を送ります。
公式資料の間で記載が異なる項目
DevDay 2026 の総括と個別資料では、次の項目の記載が一致していません(2026 年 9 月 30 日確認)。
| 項目 | DevDay 2026 Recap(総括) | 個別資料 | 本記事での扱い |
|---|---|---|---|
| API の速度 | 最大 6 倍 | Ultrafast mode ガイド: Standard の最大 8 倍 | 出典ごとに併記し、統一しない |
| ChatGPT Work / Codex の対象 | Pro 500、Enterprise | Speed: Pro 500、条件を満たす Enterprise / Edu | 契約条件まで記載した個別資料を基準にする |
| GPT-6.1 Sol の Ultrafast | 近日提供 | Speed: Standard / Fast に対応。API 料金表に掲載なし | 提供予定として扱う |
| API の Preview 対象 | 記載なし | Ultrafast mode ガイド: GPT-5.6 Sol | GPT-6.1 Sol と区別する |
API の「最大 6 倍」と「最大 8 倍」の違いについて、測定条件などの理由は公式資料から確認できませんでした。いずれも上限値であり、実際の短縮幅は、自社のプロンプト、出力の長さ、接続方式で確かめる必要があります。
DevDay 2026 の注目アップデート
DevDay 2026 では、エージェント、Codex、API、セキュリティにわたる多数の更新が発表されました。ここでは、開発と運用の担当者に関係の深い更新を用途ごとに取り上げます。発表された機能の多くは、プラン、提供地域、管理者設定によって使える範囲が異なり、Preview や Beta の段階のものも含まれます。
| 更新 | 提供状態(2026 年 9 月 30 日確認) | 対象 |
|---|---|---|
| Codex Cloud | 提供開始 | Plus、Pro、Business、Healthcare、Education、Enterprise |
| Code Review | 提供開始(GitHub は一般提供、GitLab は Preview) | 全プラン |
| Codex Security Cloud | 提供開始 | Pro、Business、Enterprise、Edu(デスクトップ、Web) |
| Agents API の Computer use | API は Beta。Codex と ChatGPT Work では Pro 500、Enterprise | API 利用者 |
| Bedrock Managed Agents, powered by OpenAI | Public Preview | AWS の米国 3 リージョン |
| ZDR with Private Safety Processing | 提供開始(ZDR の承認が前提) | API の組織とプロジェクト |
| Private Inference | 今秋に Preview 予定 | 問い合わせ受付中 |
| MCP Events | 提供開始(基となる仕様は提案段階) | 全プラン |
| Plugin extensions | 提供開始(Free / Go の Web 版は予定) | 全プラン |
Codex Cloud と Code Review
Codex Cloud は、コーディングのタスクをクラウド環境で実行する機能です。リポジトリを選ぶと Codex が依存関係やツールを準備し、公開した環境からタスクを開始します。タスクごとに作業領域が分かれ、PC がスリープしている間も作業が続きます。結果は変更ファイルとテスト結果で確認し、追加の修正を依頼するか、コミットやプルリクエストの作成へ進みます。
チームで共有する場合は、承認済みの設定と権限を持つ環境を使い回せます。環境の設定では、インターネットアクセスの範囲(パッケージマネージャーのみなど)、許可した HTTPS サービス向けのネットワークシークレット、環境を利用できる人を指定します。導入前に、外部への通信先と認証情報の渡し方を社内の開発ルールと照らし合わせておくことをおすすめします。
参考: Codex Cloud(ChatGPT Learn)
Code Review は、ChatGPT デスクトップアプリで GitHub のプルリクエストや GitLab のマージリクエストを確認する機能です。概要、差分、コメント、チェック結果を表示し、Codex に変更内容や懸念点を質問できます。GitHub の連携で自動レビューを有効にすると、Codex がクラウド上で先にレビューし、コメントを GitHub に残します。チャット内でのレビューはコメントの投稿、承認、マージを行わず、どの指摘を共有するかは利用者が選びます。ただし、Summary や Changes の画面で投稿したコメントは、Submit review を待たずにすぐ送信されます。
参考: Code review(ChatGPT Learn)
Codex Security Cloud
Codex Security Cloud は、接続した GitHub リポジトリ全体を Codex Cloud 上でスキャンするプラグインです。スキャンは任意のタイミングまたはスケジュールで実行でき、新しいコミットを継続的に確認する監視も設定できます。検出結果には、影響を受けるコード、検証の根拠、修正の指針が表示され、Codex が重複の除去と修正案の準備を行います。総括によると、別途申請なしで Daybreak Blue のモデルも利用できます。
修正案は、検出結果の Fix with Codex から生成し、内容を確認してから下書きのプルリクエストとして作成する流れです。修正が自動で本番ブランチへ反映される仕組みではなく、採用するかどうかは既存のコードレビューで判断します。利用には Codex Cloud の設定と GitHub の接続が必要で、ローカルのリポジトリをスキャンする場合は別の Codex Security プラグインを使います。GitHub に付与するアクセス範囲は、スキャン対象のリポジトリに限定することをおすすめします。
参考: Codex Security Cloud setup(ChatGPT Learn)
Agents API の Computer use
Agents API が Computer use に対応し、OpenAI がホストするブラウザ上で、エージェントに Web サイトの閲覧や操作を任せられるようになりました。アプリケーションはセッションを作成してイベントを追跡し、実行基盤は OpenAI が運用します。総括では、Codex のマルチエージェント、ツール検索、コンテキストの圧縮もアプリケーションに組み込めると説明されています。API のリクエストには OpenAI-Beta: agents=v1 ヘッダーを付ける Beta 扱いです。
ブラウザは、公開サイトを含め、新しいオリジンにアクセスするたびに利用者の承認を求めます。サインインが必要な場合は、専用のイベントで認証情報を渡し、その値はモデルの入力から除外されます。対応する方式はメールアドレス、パスワード、確認コードで、パスキーと QR コードには対応していません。
参考: Computer use(OpenAI API ドキュメント)
“Origin approval does not enforce confirmation before individual actions”
(オリジンの承認は、個々の操作の前に確認を強制するものではありません)
https://developers.openai.com/api/docs/guides/agents-api/tools/computer-use
購入や破壊的な変更の前に確認を保証したい場合は、ホスト型ブラウザがアクセスできるリソースを制限するか、自社で管理するブラウザ実行環境を使うよう案内されています。Web サイトの内容は信頼できない入力として扱い、スクリーンショットにも機微な情報が含まれうる点に注意が必要です。権限、承認、停止条件の設計の考え方は、『AI エージェントはなぜ逸脱したのか|OpenAI 事案に学ぶ制御設計』で整理しています。
Bedrock Managed Agents, powered by OpenAI
Bedrock Managed Agents は、AWS と OpenAI が共同で開発したエージェントの実行サービスです。OpenAI のモデルと Codex のハーネスを Amazon Bedrock AgentCore と組み合わせ、エージェントの実行とモデルの推論を AWS の中で完結させます。各エージェントは独自の AWS の ID と権限で動作するため、既存の IAM やガバナンスの仕組みでアクセス範囲を管理できます。
AWS の資料では Public Preview と明記され、機能や API が変わる可能性があるとされています。ツールは利用者が用意する実行環境(自前のホストまたは AgentCore Runtime)で動作し、提供リージョンは米国東部(バージニア北部)、米国西部(オレゴン)、米国東部(オハイオ)の 3 つです。料金はモデルの推論と利用する AWS リソースに対して発生し、AgentCore のサンプル構成には、エージェントが動いていない間も課金される NAT ゲートウェイが含まれます。国内リージョンでのデータ処理を前提とする場合は、提供リージョンを先に確認してください。
参考: Amazon Bedrock Managed Agents, powered by OpenAI(AWS) / 提供リージョン、Preview、料金の記載(Amazon Bedrock User Guide)
Private Intelligence(ZDR with PSP と Private Inference)
Private Intelligence は、企業のデータ保護に関する取り組みの総称で、現時点で使えるものと今後提供されるものが混在しています。提供済みの ZDR with Private Safety Processing(PSP)は、OpenAI の担当者が内容にアクセスしない形で、自動の安全性レビューを行う仕組みです。
参考: ZDR with Private Safety Processing(OpenAI API ドキュメント)
“Customer content is stored in customer-controlled storage.”
(顧客のコンテンツは、顧客が管理するストレージに保存されます)
https://developers.openai.com/api/docs/guides/private-safety-processing
安全性の分類器による照会や承認済みのサンプリング方針で選ばれたやり取りは、暗号化されて利用者の AWS S3、Azure Blob Storage、Google Cloud Storage に書き込まれます。OpenAI 側が保持するのは運用メタデータとストレージへの参照で、内容の複製は持ちません。復号は、人のアクセスを無効化したハードウェア認証済みの実行環境でのみ行われ、利用者管理の鍵(EKM)による外側の暗号化も推奨されています。ZDR with PSP は「どこにも保存されない」仕組みではなく、対象となったやり取りを自社のストレージで 30 日以上保持する運用を伴います。
PSP はプロジェクト単位で有効化され、有効にしたプロジェクトのすべての API 通信に適用されます。利用には組織が ZDR の承認を受けていることが前提で、ストレージの登録と検証は組織の管理者が行います。一方、機密計算と検証可能な管理を組み合わせる Private Inference は、DevDay 2026 Recap によると今秋に Preview を始める予定の段階で、現時点では利用できません。
MCP Events と Plugin extensions
MCP Events は、MCP サーバー側の出来事を契機に ChatGPT が作業を始める仕組みです。例えば、利用者が「プロジェクトボードの新しいタスクを監視し、届いたら関連文書を読んで計画案を作る」と指示すると、ChatGPT がイベントを購読し、該当するイベントが届いた時点で指示どおりに処理します。配信は Webhook で行われ、Standard Webhooks の署名で検証されます。
ChatGPT で使うには、MCP サーバーがプロトコルバージョン 2026-07-28(MCP 2.0)に対応している必要があります。基となる MCP Events の仕様は提案段階のドラフトで、ポーリングやストリーミングによる配信には対応していません。公式ガイドは、コメントなど利用者が書いたテキストはデータとして扱い、イベント本文にモデルへの指示を含めないよう求めています。利用者が不在の間に処理が進むため、イベントを契機に実行してよい操作の範囲を先に決めておくことをおすすめします。
参考: MCP Events(OpenAI Developers)
Plugin extensions は、OpenAI が ChatGPT の機能開発に使う基盤を開放し、プラグインが ChatGPT の画面に組み込まれる仕組みです。サイドバーからのアプリ起動、会話の横に開くパネル、プラグインの設定画面、対応ファイルのビューアーとエディター、入力欄でのメンション、画像を選べるフォームなどを追加できます。入力欄のメンションはデスクトップアプリのみで、Free と Go の Web 版は今後の提供予定です。
参考: Plugin Extensions(OpenAI Developers)
そのほかの発表
ChatGPT の共同作業や認証に関する更新も発表されています。概要と提供条件は次のとおりです。
| 更新 | 概要 | 提供状態・対象 |
|---|---|---|
| dots | 専用のクラウドコンピューターで継続して作業する常時稼働型のエージェント | Pro、Business Premium。Enterprise、Edu、Healthcare はベータで既定オフ |
| GPT-6.1 Sol | Astra に近い性能を低い単価で提供する Sol 系の新モデル | API と、Plus、Pro、Business、Enterprise、Edu の ChatGPT Work / Codex |
| ChatGPT Space / Pages | チームと ChatGPT が共有の文脈で作業する場と、共同編集できる新しい文書形式 | Pro、Business、Enterprise。モバイルは閲覧と共有のみ。共同編集のスライドは数週間以内 |
| @ChatGPT in Slack / Microsoft Teams | チャンネルやスレッドで @ChatGPT を呼び出し、接続済みツールを使って作業する | Business、Enterprise(機能ページには Edu も記載)。管理者による設定が必要 |
| Sign in with ChatGPT | ChatGPT アカウントで外部アプリにサインインし、プランの利用枠を使わせる | サインインは全利用者。利用枠の共有は Plus / Pro で、アプリごとに週次上限を設定可能 |
| Decisions API | 定義済みの選択肢から判断を返す API。分類、振り分け、エージェントの次の行動の選択に使う | 限定 Preview。数日以内に広く提供予定 |
参考: ChatGPT Space(ChatGPT) / ChatGPT in Slack and Microsoft Teams(ChatGPT) / Using your ChatGPT plan in other apps and sites(OpenAI Help Center) / DevDay 2026 Recap(dots、GPT-6.1 Sol、Decisions API の提供条件)
@ChatGPT in Slack / Microsoft Teams は、個別の ChatGPT ライセンスがないメンバーも有効化されたチャンネルで利用でき、接続ツールで操作を行う前に承認を求めます。Sign in with ChatGPT で外部アプリにプランの利用枠を使わせる場合、枠を使い切った後にクレジットを使わせる設定は既定でオフです。dots と現行 Claude の違いや利用条件は、『OpenAI dots とは|Claude Cowork との違いと利用条件』で比較しています。
自分に関係する更新と導入前の確認
更新の数が多いため、立場ごとに関係する更新と、試す前に確認することを整理します。そのうえで、Ultrafast の効果を評価する手順を示します。
立場別に関係する更新
| 立場 | 関係する更新 | 試す前に確認すること |
|---|---|---|
| ChatGPT / Codex の個人利用者 | Ultrafast、Codex Cloud、Code Review、Sign in with ChatGPT | 契約中の Pro の種類、利用枠とクレジットの消費倍率、外部アプリに許可する週次上限 |
| API を使う開発者 | Ultrafast(API)、Agents API の Computer use、MCP Events、Plugin extensions、Decisions API | TPM の上限、処理リージョン、Beta と Preview による仕様変更、Web の内容とイベント本文を信頼しない設計 |
| 情報システムの管理者 | Enterprise の Ultrafast、ChatGPT Space / Pages、@ChatGPT in Slack / Teams、dots | 既定でオフの機能を許可する範囲、ユーザー別の支出制御、接続ツールと共有の範囲 |
| セキュリティ担当者 | Codex Security Cloud、ZDR with PSP、Private Inference | GitHub に付与する権限、修正案のレビュー手順、PSP 用ストレージの保持期間と鍵の管理、Private Inference の提供時期 |
| AWS の利用者 | Bedrock Managed Agents | 提供リージョン、Preview の制限事項、常時課金される AWS リソース |
高速化を評価するときの確認項目
Ultrafast の効果は、作業に占める生成時間の割合によって変わります。導入の判断には、同じ条件で Standard と比べることをおすすめします。次の手順は当ブログで実測した結果ではなく、評価を進めるための提案です。
同じモデル(GPT-6 Astra)、同じ推論設定、同じ入力、ツール、プロンプトを使い、速度の階層だけを変えます。API では接続方式(HTTP または WebSocket)もそろえ、プロンプトキャッシュの一致状況も記録します。
最初の応答が返るまでの時間、生成速度(出力トークン数 ÷ 生成時間)、タスク全体の完了時間を別々に記録します。ツールの実行、テスト、外部 API の待ち時間も分けて記録すると、生成以外の時間がどれだけを占めるかを把握できます。
出力の正確さ、指定した形式への準拠、テストの合否が Standard と同等かを確認します。費用は、API ではレスポンスの使用量から計算し、ChatGPT Work / Codex では利用枠とクレジットの消費量を記録して、1 タスクあたりで比べます。
生成時間の割合が高く、待ち時間の短縮が業務上の価値を持つ作業から適用します。外部ツールやテストの待ち時間が大部分を占める作業では、生成速度の倍率だけで効果を判断できないため、計測したタスク全体の時間と費用で Standard や Fast と比べて決めます。
Enterprise では、Ultrafast の利用に既存のユーザー別支出制御が適用されます。評価期間中は試験ユーザーに限定して許可し、支出の上限を設定しておくと、想定外の費用増加の防止につながります。
まとめ
Ultrafast は GPT-6 Astra の生成を高速化する上位のサービス階層で、ChatGPT と API では対象条件と課金の仕組みが異なります。生成速度の倍率はタスク全体の短縮率ではないため、自社の作業で時間と費用を比べてから適用範囲を決めることをおすすめします。DevDay 2026 のほかの更新も、提供状態と管理者設定を確認してから試す必要があります。
- Ultrafast は新モデルではなく、実行速度を選ぶサービス階層
- ChatGPT で使えるのは Pro 500 と条件を満たす Enterprise / Edu
- Pro 100 / Pro 200 はクレジットを購入しても提供開始時点で対象外
- Pro 500 は利用枠を 8 倍、その後のクレジットを 6 倍で消費します。
- API の単価は Standard の 6 倍で、US 以外のリージョナル処理は非対応
- 生成速度の最大 8 倍は、タスク全体の短縮率を示すものではない。
- 注目更新には Preview や Beta も多く、管理者設定の確認が前提
以上、最後までお読みいただきありがとうございました。